基本情報の回帰分析は、数量データの関係を式で表し、一方の値からもう一方の値を説明・予測するための考え方です。「売上などの数値を予測する手法」とだけ覚えるより、何を入力し、何を予測し、どのくらいずれるのかまで確認すると理解が進みます。
この記事では、説明変数が一つの線形単回帰を扱います。四つの架空データから傾きと切片を求め、予測値、残差、決定係数まで計算します。分類・クラスタリングなどの手法一覧ではなく、回帰式を読み、計算し、使える範囲を判断することが中心です。
回帰式の当てはまりが良くても、因果関係や将来の結果が保証されるわけではありません。数値を出した後に何がいえるのか、何はいえないのかも分けて押さえましょう。
- 説明変数と目的変数を逆にしない回帰式の読み方
- 平均・偏差積和・偏差平方和から傾きを求める手順
- 実測値と予測値の差である残差の計算方法
- 決定係数・外挿・因果関係を区別する判断ポイント
基本情報の回帰分析の仕組みをつかむ
入力と予測対象を決める
回帰分析で予測の手掛かりにする値を説明変数、予測したい値を目的変数と呼びます。例えば、処理するファイル数から処理時間を見積もるなら、説明変数xはファイル数、目的変数yは処理時間です。一つの観測について、xとyが対になっている必要があります。
「ファイル数の一覧」と「別の日に測った処理時間の一覧」を、対応を考えずに組み合わせてはいけません。同じ条件で対応する観測をまとめて初めて、関係を調べられます。データ数が同じというだけでは、対応が取れていることになりません。
単回帰は説明変数が一つ、重回帰は説明変数が複数の回帰です。ファイル数だけから時間を予測するなら単回帰、ファイル数と合計容量などを一緒に使うなら重回帰を考えます。「単」は目的変数と説明変数を合計して変数が一つ、という意味ではありません。
ここでは予測式をyの予測値=a+bxと書きます。aは切片、bは傾きです。実際のyと区別するため、予測値には通常yの上へ記号を付けますが、本文では読みやすく「予測値」と呼びます。実測値が必ず式の上に載るわけではないことがポイントです。
総務省統計局の相関と回帰の解説でも、二つの変数の立場を分けて予測する考え方が示されています。何を予測する式かを、変数名と単位で最初に固定しましょう。
傾きと切片の意味を読む
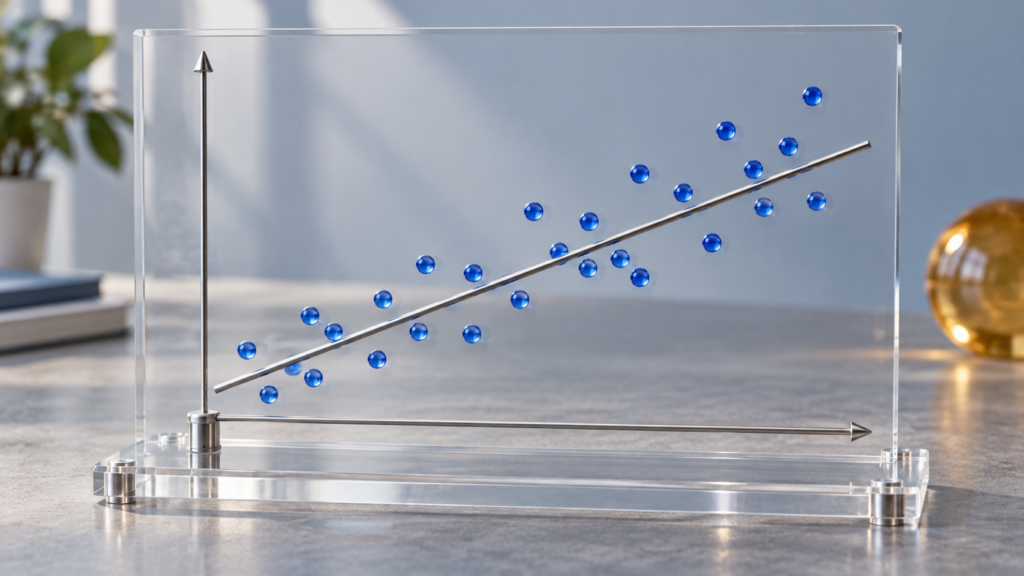
学習用に、予測値=1+1.2xという回帰式を考えます。xの単位がファイル、yの単位が秒なら、傾き1.2の単位は秒/ファイルです。ファイル数が一つ増えたとき、予測される処理時間が1.2秒増えるという、式の上での関係を表します。
傾き1.2を「相関係数が1.2」と読むのは誤りです。相関係数は−1から1の範囲ですが、傾きは単位に依存し、この範囲へ制限されません。秒をミリ秒へ変えれば、同じ関係でも傾きの数値は1000倍になります。
切片1は、x=0を式へ入れたときの予測値が1秒という意味です。ただし、観測範囲に0ファイルがなく、0の状態でも同じ仕組みが続くと確認できなければ、「必ず1秒の固定処理が存在する」とまで断定できません。切片の数学的な意味と、実際の原因の説明は別です。
また、yをxから予測する式を作ることと、xをyから予測する式を作ることは同じではありません。もとの回帰式を単純に移項すれば、逆向きの最小二乗回帰が得られるわけではありません。どちらの方向の残差を小さくして当てはめたかが違うためです。
問題文が「xが与えられたときのy」を求めているなら、xを入力側に置きます。aやbの記号は教材によって逆の場合もあります。式のどの項がxに掛かっているかを見て、係数の名前だけで傾きや切片を決めないようにしましょう。
残差は縦方向のずれ
残差は、実測値から予測値を引いた値です。実測4秒、予測3.4秒なら、残差は4−3.4=0.6秒です。プラスなので、実際の値が予測より大きかったことを意味します。実測4秒、予測4.6秒なら、残差は−0.6秒です。
散布図でxを横、yを縦に置いた通常の回帰では、残差は同じxにおける縦方向の差です。点から斜めの回帰直線へ、直角に引いた最短距離ではありません。この違いは、最小二乗法で何を小さくしているかを理解するうえで大切です。
残差を単純に合計すると、プラスとマイナスが打ち消し合うことがあります。そこで、残差を二乗して足した値を、当てはめの基準にします。二乗した値は負にならず、大きなずれには大きな値が対応します。
ただし、残差の二乗和が小さいことだけで、使う場面に適した予測モデルと決まるわけではありません。データの単位、観測件数、比較する対象がそろっているかを確認する必要があります。秒とミリ秒のデータの二乗和を、そのまま数値の大小だけで比べるのは適切ではありません。
東京都立大学の回帰分析教材では、回帰直線と残差、係数の計算を学べます。ここでは、実測から予測を引く向きと、二乗してから足す順番を、具体的な数値で確かめます。
最小二乗法が選ぶ直線
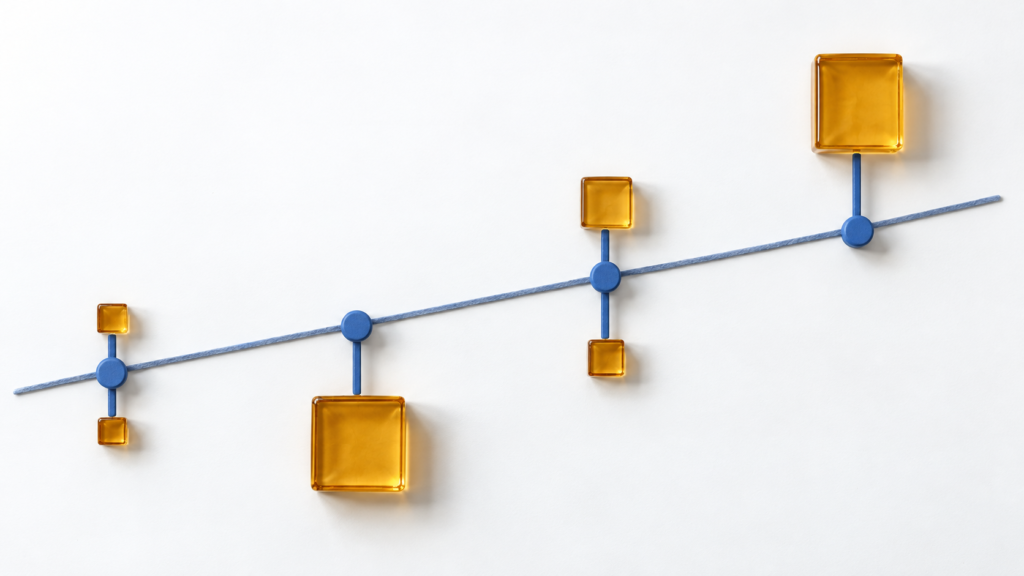
最小二乗法は、この残差の二乗和が最も小さくなるように係数を決める方法です。通常の切片を含む線形単回帰では、傾きbはxとyの偏差積和をxの偏差平方和で割り、切片aはyの平均からbとxの平均の積を引いて求められます。
式の形では、b=Σ{(x−xの平均)(y−yの平均)}/Σ{(x−xの平均)²}、a=yの平均−b×xの平均です。Σは、観測したすべての組について足す記号です。平均からのずれを計算して、分子と分母を別々の列へまとめると見失いにくくなります。
分母はxのばらつきに対応します。すべてのxが同じなら分母が0となり、この式で傾きを決められません。xが変わったときにyがどう変わるかを調べたいのに、xが一種類しかない、という状況です。割り算を無理に続けるのではなく、データの条件を確認します。
切片を含む通常の最小二乗直線は、xの平均とyの平均の点を通ります。係数を求めた後、xの平均を代入してyの平均が出るかを確認すれば、切片や符号の計算ミスを見つける手掛かりになります。ただし、原点を必ず通すよう切片を0へ固定した別のモデルへ、この性質をそのまま当てはめないでください。
統計量の分散や標準偏差と似た計算が出てきますが、この記事の目的は回帰式を作ることです。ばらつきの基本を確認したい場合は、基本情報の標準偏差と分散の計算へ戻ると、平均からのずれを二乗する操作を整理できます。
基本情報の回帰分析を例題で計算する
四つのデータから式を作る
次の値は、計算を追いやすくするためにこの記事用に作成した架空データです。実在するシステムの測定結果や処理性能を示すものではありません。xをファイル数、yを処理時間の秒とし、四つの観測を表へ整理します。
| 観測 | x | y | xの偏差 | yの偏差 | 偏差の積 | xの偏差の二乗 |
|---|---|---|---|---|---|---|
| A | 1 | 2 | −1.5 | −2 | 3 | 2.25 |
| B | 2 | 4 | −0.5 | 0 | 0 | 0.25 |
| C | 3 | 4 | 0.5 | 0 | 0 | 0.25 |
| D | 4 | 6 | 1.5 | 2 | 3 | 2.25 |
| 合計 | 10 | 16 | 0 | 0 | 6 | 5 |
xの平均は10/4=2.5、yの平均は16/4=4です。各観測から平均を引くと、表の偏差になります。分子の偏差積和は3+0+0+3=6、分母のxの偏差平方和は2.25+0.25+0.25+2.25=5です。
したがって傾きbは6/5=1.2、切片aは4−1.2×2.5=1です。回帰式は予測値=1+1.2xとなります。xの平均2.5を代入すると1+3=4で、yの平均を通ることも確認できます。
ここでは、最初と最後の二点だけで直線を結んだわけではありません。最小二乗法は、すべての観測の残差を考えています。端の二点から計算した直線と一致するデータもありますが、一般に同じとは限りません。
もし問題で回帰式そのものが与えられているなら、毎回この表を作り直す必要はありません。設問が係数の導出なのか、式への代入なのか、残差の計算なのかを確認し、必要な工程だけを行うと時間を使い過ぎずに済みます。
予測値と残差を照合する
x=2なら予測値は1+1.2×2=3.4秒です。実測値は4秒なので、残差は0.6秒です。x=3なら予測値は4.6秒で、実測4秒との差は−0.6秒です。同じ実測4秒でも、入力xが違えば予測値と残差が異なります。
| x | 実測値 | 予測値 | 残差 | 残差の二乗 |
|---|---|---|---|---|
| 1 | 2 | 2.2 | −0.2 | 0.04 |
| 2 | 4 | 3.4 | 0.6 | 0.36 |
| 3 | 4 | 4.6 | −0.6 | 0.36 |
| 4 | 6 | 5.8 | 0.2 | 0.04 |
| 合計 | 16 | 16 | 0 | 0.8 |
残差の合計は0ですが、すべての観測が正しく予測されたわけではありません。残差の二乗和は0.8で、ずれが残っています。切片を含む通常の最小二乗法で残差が打ち消し合うことと、誤差が一つもないことを混同しないようにしましょう。
比較として、すべてのxでyの平均4秒を予測する水平線を考えます。この場合の残差の二乗和は、(2−4)²+0²+0²+(6−4)²=8です。今回の回帰直線では0.8なので、この四つのデータには、平均だけを使う予測よりよく当てはまっています。
ただし、これは同じ四つの観測への当てはまりの比較です。将来の観測でも同じ精度となる保証ではありません。学習に使ったデータでの評価と、別のデータでの予測結果を分けて扱うことが必要です。
同じデータで、今度は処理時間yからファイル数xを予測する直線を作ると、傾きは偏差積和6をyの偏差平方和8で割った0.75です。切片は2.5−0.75×4=−0.5なので、xの予測値=−0.5+0.75yとなります。元の式を移項したx=(y−1)/1.2とは一致しません。元のモデルは縦方向の差を、新しいモデルは横方向の差を小さくするよう作るためです。
この違いは、同じデータから作った式でも予測する向きが重要なことを示します。ファイル数から時間を見積もりたい問題で、逆向きの係数を使わないようにしましょう。どちらのモデルも平均の点を通るので、平均だけを代入すると一致する場合があります。平均以外の値でも確認すると、式を取り違えたことに気付きやすくなります。
決定係数を正答率と読まない
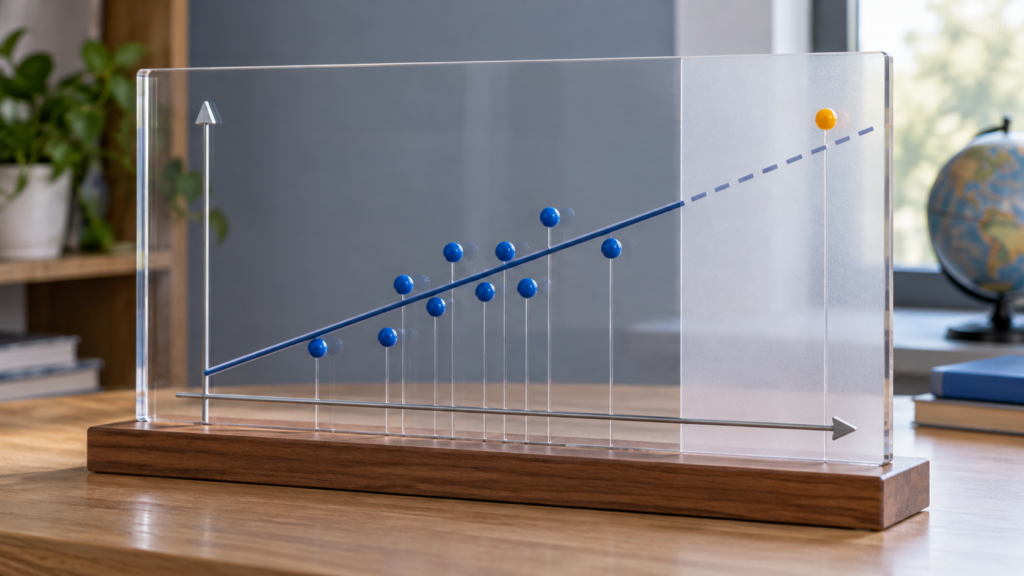
切片を含む通常の最小二乗回帰では、決定係数R²は1−残差平方和/全体の偏差平方和で求められます。全体の偏差平方和とは、各yからyの平均を引いて二乗し、合計したものです。今回なら1−0.8/8=0.9です。
0.9という値は、このデータのyのばらつきについて、平均だけの予測に比べ、当てはめたモデルがどれだけ説明しているかを表す指標です。「将来の予測が90%の確率で当たる」「各観測の誤差が必ず10%以内」という意味ではありません。
通常の切片あり単回帰では、R²はピアソンの相関係数rの二乗に一致します。ただし、相関の方向は二乗すると消えます。傾きが負の直線でもR²は大きくなり得るため、R²が正だから正の相関、と判断しないようにします。
また、相関係数が0付近でも、曲線的な関係がある場合があります。直線で説明するモデルに合わないデータを、数値一つだけで無関係と判断しないことが大切です。散布図、変数の意味、観測条件を合わせて見ます。
この区別は、統計局の複数変数の関係性の解説でも確認できます。今回の四つのデータは仕組みを学ぶための小さな例なので、実務で十分なモデルを作れたという評価には使いません。
今回の相関係数も確認するなら、偏差積和6を、xの偏差平方和5とyの偏差平方和8の積の平方根で割ります。6/√40で約0.949です。二乗すると0.9となり、先ほどの決定係数と一致します。傾き1.2とは異なる数値であることも確認できます。
処理時間の単位を秒からミリ秒へ変えれば、回帰式は予測値=1000+1200xになります。切片と傾きは1000倍になりますが、対応するデータの関係そのものは変わらず、相関係数や今回の決定係数は変わりません。単位を変えるだけでモデルが良くなったと評価しないためにも、係数の単位と、単位に依存しない指標を分けて読むと役立ちます。
外挿・外れ値・因果に注意する
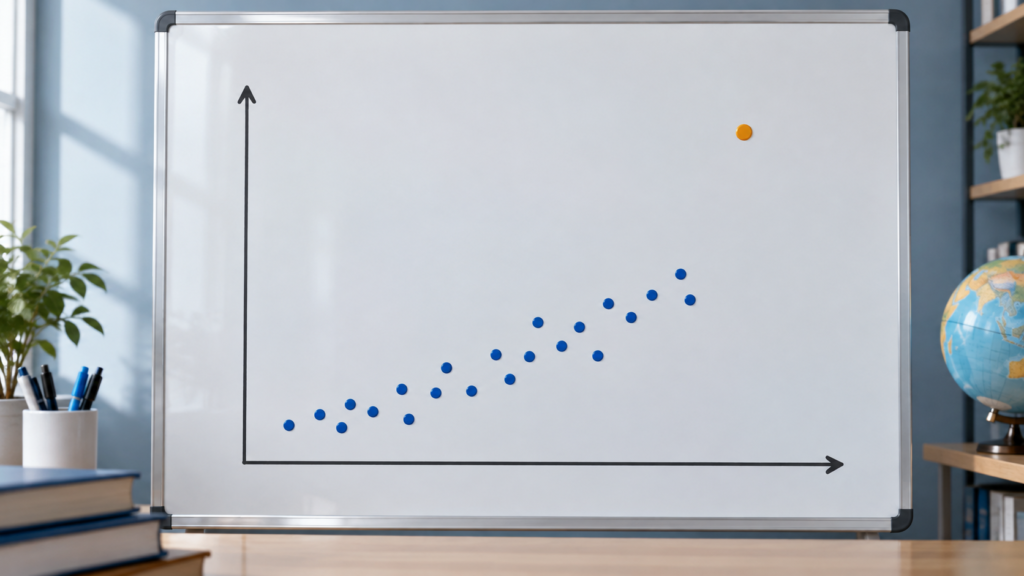
今回のxの観測範囲は1から4です。式へx=5を代入すれば予測値7秒と計算できますが、これは観測範囲の外へ式を延ばす外挿です。計算できることと、その範囲で同じ関係が成り立つと確認できたことは別です。
ファイル数を極端に増やすと、メモリ不足や待ち時間など、元の範囲では表れなかった条件が影響するかもしれません。実際にそうなるという断定ではなく、観測範囲を超えた予測には追加の確認が必要、という意味です。小さなデータから大きな範囲へ無条件に広げないようにします。
外れ値も結果へ影響します。四つの観測へ、x=5、y=30という点を一つ追加すると、同じ最小二乗法でも傾きは5.8、切片は−8.2になります。元の1.2と1から大きく変わります。これは架空の計算例ですが、少数の大きなずれが係数へ影響することを確認できます。
外れた点を見つけたら、見栄えのよい直線にするためだけに削除してはいけません。入力ミスか、違う動作条件か、重要な現象かを確認します。説明のつかない観測を除外した場合は、その条件や理由が必要です。数値を小さくすることだけを目的にしないようにしましょう。
相関や回帰の傾きだけで、因果関係も確定しません。例えば、処理時間とファイル数が一緒に増えていても、ファイル容量や別の設定が関係している可能性があります。説明変数という名前も、必ず原因を特定できたという意味ではありません。
データマイニングの中で回帰をどこに位置付けるかは、基本情報のデータマイニングの手法分類で確認できます。ここでは「数値を予測する」という目的から一歩進み、式の作り方と、式を解釈するときの条件を押さえます。
基本情報の回帰分析のまとめ
回帰式を読むときは、説明変数と目的変数の向きを決め、単位を付けて傾きと切片を確認します。係数を求めるなら平均と偏差を表にし、予測値を求めた後に、実測値との差を残差として確認する順番です。
復習では、今回の四つのデータから傾き1.2、切片1、残差平方和0.8を再現してみてください。続いて、決定係数0.9が予測の正答率を意味しない理由を一文で説明できれば、計算と解釈を結び付けられています。
さらに練習する場合は、基本情報の過去問アプリで関連する分野を選び、設問が手法の分類、代入、係数の計算、解釈のどれを求めているかを確認しましょう。この架空データと同じ問題が収録されているという案内ではありません。
コメント