基本情報のベイズの定理で最初に区別したいのは、「迷惑メールなら警告される確率」と「警告されたメールが迷惑メールである確率」です。言葉は似ていますが、分母にする集団が異なるので、同じ数値にはなりません。
ベイズの定理は、ある結果を観測した後に、元の分類や仮説の確率を求めるために使えます。式を暗記する前に、全体を二つの分類へ分け、それぞれから同じ観測結果に至る件数を数えると、分子と分母の意味が見えてきます。
この記事では、架空のメール判定を使い、割合を件数へ置き換える方法と公式の両方で解きます。後半は工場の不良品という別の例へ移し、表現が変わっても同じ考え方を使えるか確認します。数値はすべて学習用で、実在するサービスの性能を示すものではありません。
- 条件付き確率の右側にある条件から分母を決める方法
- 同じ警告へ至るすべての経路を分母へ足す考え方
- 検出率と警告後の確率が一致しない理由
- 事前確率の変化や独立性を確かめて計算する手順
基本情報のベイズの定理の仕組み
条件を付けると分母が変わる
P(A|B)は、Bという条件の下でAが起こる確率です。縦線の右側を先に読み、「Bであるものに対象を絞ったとき、その中でAでもある割合」と考えます。AとBの両方を満たす件数を、Bを満たす件数で割る形です。
例えば、100件のメールのうち20件が迷惑メールで、その20件のうち18件へ警告が出たとします。「迷惑メールを警告する確率」は18/20=90%です。ここでは最初に迷惑メールであることを条件としているので、分母は全100件ではなく20件です。
しかし、「警告が出たメールが迷惑メールである確率」を求めるには、警告されたメールの総数が必要です。通常のメールにも警告が出ていれば、その件数も分母へ入ります。最初の18/20だけでは、逆向きの確率を決められません。
この区別は、分類の名前を変えても同じです。「不良品なら検査で検出される」「検出された製品が不良品である」は別の条件付き確率です。求める文章を、そのままP(求める分類|分母となる条件)へ書き直す習慣を付けると、向きの取り違えを減らせます。
高知県立大学の条件付き確率の教材では、クロス集計表と確率の関係を学べます。式の記号だけで迷ったときは、対象を絞った表のどの行・列を分母にするかへ戻って考えましょう。
事前確率と条件付き確率
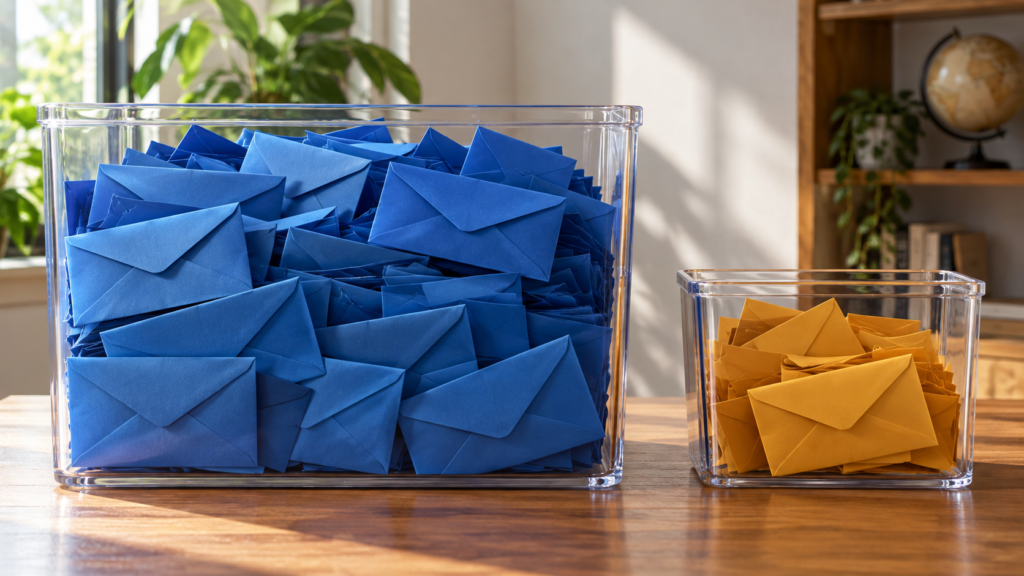
事前確率は、今回の観測結果を見る前に、その分類へどのくらい当てはまると考えるかを表します。メール全体の2%が迷惑メールとする設定なら、迷惑メールの事前確率は0.02です。残り98%は通常メールとして扱います。
一方、「迷惑メールなら警告が出る確率」を0.9、「通常メールでも警告が出る確率」を0.05とします。前者は迷惑メールの集団の中での割合、後者は通常メールの集団の中での割合です。基準となる集団が違うため、0.9と0.05をそのまま足して全体の警告率にすることはできません。
それぞれを全体の中での割合へ直すには、分類の割合を掛けます。迷惑メールかつ警告なら0.02×0.9、通常メールかつ警告なら0.98×0.05です。この二つは同時には起こらない分類から来るので、足すと全体で警告される割合になります。
ここで掛け算を使うために、迷惑メールであることと警告されることが独立である必要はありません。P(AかつB)=P(A)×P(B|A)という、条件付き確率の乗法規則を使っています。独立の場合だけ使えるP(A)×P(B)とは区別してください。
事前確率は、現実なら対象集団や観測条件によって変わることがあります。ある組織で集めたメールの割合を、別の組織へそのまま適用できるとは限りません。学習用問題では与えられた値を使い、実務ではその値が何を母集団としているかを確かめます。
全体の確率を経路で足す
迷惑メールである事象をS、警告が出る事象をFとします。今回の設定はP(S)=0.02、P(F|S)=0.9、P(F|通常)=0.05です。通常メールの割合は1−0.02=0.98になります。
警告へ至る経路は、「迷惑メールで警告」と「通常メールで警告」の二つです。全体の警告率P(F)は、0.02×0.9+0.98×0.05=0.018+0.049=0.067です。全体では6.7%のメールに警告が出る設定と分かります。
分類ごとに結果を分けた樹形図を描くと、途中では掛け、同じ観測結果へ至る経路を最後に足す、という順番になります。枝の0.9と0.05だけを足さず、それぞれの枝へ入る0.02と0.98も掛けることが大切です。
この分解では、迷惑メールと通常メールが互いに重ならず、全体を尽くすと定義しています。第三の分類が存在する設定なら、その経路も必要です。また、同じメールを複数の分類へ重ねて数えると、足し算で二重計上してしまいます。
集合の整理で迷った場合は、基本情報の集合演算と人数の数え方を確認すると、重なりと全体の関係を整理できます。ベイズの定理でも、何を排反な分類として足すかが土台になります。
公式は共通部分から導く
求めたいP(S|F)は、警告されたメールの中で迷惑メールである割合です。分子は迷惑メールかつ警告という共通部分、分母は警告全体です。したがってP(S|F)=P(F|S)×P(S)/P(F)となります。
分母を二つの経路へ展開すると、P(S|F)={P(F|S)×P(S)}/{P(F|S)×P(S)+P(F|通常)×P(通常)}です。分母には分子と同じ迷惑メールの経路も含まれます。通常メールの経路だけで割ると、割合ではなく別の比になります。
一般形では、P(A|B)=P(B|A)×P(A)/P(B)です。P(B)が0ではないことが必要です。観測する条件Bの確率が0という設定では、この形の割り算で条件付き確率を求められません。計算の途中で0を分母にしないようにします。
スタンフォード大学のベイズの定理の解説でも、分かっている条件付き確率と逆向きの確率を結ぶ方法が説明されています。覚えるときは「事前×その分類からの観測確率」を作り、「同じ観測へ至る全経路」で割ると整理できます。
分数の向きに自信がなくなったら、分母の集団へ分子が含まれているかを確かめてください。警告全体の中には、迷惑メールで警告されたものも、通常メールで警告されたものもあります。この包含関係を説明できれば、式を再現しやすくなります。
基本情報のベイズの定理を例題で解く
一万件の表に置き換える
ここからは、先ほどの確率を1万件のメールへ当てはめた独自の学習用例です。迷惑メールは1万×0.02=200件、通常メールは9800件です。迷惑メールのうち90%に警告が出るので180件、出ないものは20件です。
通常メールのうち5%に誤って警告が出るので、9800×0.05=490件です。残り9310件には警告が出ません。この四つを、実際の分類と判定結果の二軸で整理します。ここでの件数は、確率の意味を分かりやすくするための設定です。
| 実際の分類 | 警告あり | 警告なし | 合計 |
|---|---|---|---|
| 迷惑メール | 180件 | 20件 | 200件 |
| 通常メール | 490件 | 9310件 | 9800件 |
| 合計 | 670件 | 9330件 | 10000件 |
警告されたものの中で迷惑メールなのは、180/670=18/67で約26.9%です。分母は警告ありの列の合計670件であり、迷惑メール全体200件ではありません。180/200とすると、与えられた検出率90%をもう一度計算しただけになります。
割合の式でも、0.018/(0.018+0.049)=0.018/0.067で同じ答えになります。件数へ直した方法と公式の方法が一致することを確認すれば、式のどこに何を入れるかを理解できます。小数の丸めは最後に行いましょう。
検出率が高くても結論は変わる
今回の設定では迷惑メールを90%検出できますが、警告されたメールのうち本当に迷惑なのは約26.9%でした。直感と違って見える理由は、通常メールの母数が9800件と大きいことです。その5%である490件が、正しく警告された180件を上回っています。
ここでは、迷惑メール全体の2%という事前確率から、警告を見た後には約26.9%へ上がっています。警告に情報がないわけではありません。しかし、90%という検出率と同じ確率へ上がるわけでもありません。事前と事後、それぞれを比較すると変化の意味を読みやすくなります。
もし通常メールの誤警告率を5%から1%へ下げ、ほかの条件を同じとするなら、通常メールで警告されるのは98件です。警告全体は180+98=278件となり、迷惑メールである割合は180/278で約64.7%です。検出率90%を変えなくても、誤警告の条件が変わると事後確率が変わります。
ただし、この数値を実際の製品へ当てはめた評価と受け取らないでください。あくまで、与えられた確率を変えたときの計算例です。警告されたものをどう処理するかには、誤って通常メールを止める影響など、確率以外の判断材料も必要です。
総務省統計局の迷惑メール判別の解説でも、特徴が現れる条件付き確率だけでなく、通常メールと迷惑メールの割合が必要と説明されています。本記事では単語の出現そのものではなく、警告結果を観測として計算を練習しています。
判定全体の正答率も、今回の事後確率とは違う指標です。表で正しい判定は、迷惑メールで警告された180件と、通常メールで警告されなかった9310件の合計9490件です。全体の正答率は9490/10000=94.9%ですが、警告されたものの中で迷惑メールである割合は約26.9%のままです。
94.9%、90%、26.9%は矛盾する数値ではありません。順に、全メールの中の正しい判定、迷惑メールの中で警告できた割合、警告の中で迷惑メールだった割合を表し、分母が違うためです。問題に「正答率」という言葉だけがある場合も、その定義や何を正解として数えるかを確認しましょう。ある一つの指標だけから、別の条件付き確率を作り出すことはできません。
母集団と観測結果を変える
迷惑メールの割合が20%の別集団を考えます。検出率90%、通常メールの誤警告率5%が同じという仮定なら、1万件中の迷惑メール2000件から1800件へ警告が出て、通常メール8000件から400件へ警告が出ます。
したがって、警告後の迷惑メールの確率は1800/(1800+400)=9/11で約81.8%です。元の約26.9%との差は、同じ条件付き確率でも、最初の分類の割合が異なるために生じています。判定装置の検出率だけでは、警告後の確率を一意に決められないことが分かります。
次に、元の2%の集団で、警告が出なかった場合を考えます。分母は警告なしの9330件、分子はその中の迷惑メール20件です。20/9330で約0.214%となります。警告なしだから確率が0、と自動的に判断することはできません。
この値を「警告後の約26.9%」の補数とするのも誤りです。1−26.9%は、警告されたという同じ条件の中で、通常メールである確率です。警告なしという別の条件へ変えるときは、分母から計算し直します。
求める条件を変えるたびに、表のどの行・列へ対象を絞るかを指で示すようにすると、補数を使える場面と使えない場面を区別できます。「逆の確率」「反対の結果」という曖昧な言葉を、条件と分類のどちらを変えるのかへ分解しましょう。
反対に、どちらの分類でも警告される確率が同じ10%だったらどうでしょうか。迷惑メールの事前確率を2%とすると、全体の警告率は0.02×0.1+0.98×0.1=0.1です。警告後の迷惑メールの確率は0.002/0.1=0.02で、事前と同じ2%になります。
この設定では、警告を観測しても分類についての確率が変わりません。警告の出やすさが分類によって変わらないためです。実際のデータにこの条件が成り立つかは別に確認が必要ですが、条件付き確率と独立性を結び付ける学習用の例になります。警告という名前が付いているだけで、必ず有力な情報だと判断しないことも大切です。
不良品の出所も同じ手順で解く
別の独自例題として、工場Aが全製品の60%、工場Bが40%を作り、Aの不良率が1%、Bの不良率が3%とします。製品はAかBのどちらかで作られ、製品全体から無作為に一つ選ぶ設定です。不良品だったとき、Bで作られた確率を求めます。
B製かつ不良という経路の割合は0.4×0.03=0.012です。不良品全体は、A製の0.6×0.01=0.006と、B製の0.012を足して0.018です。したがって、求める確率は0.012/0.018=2/3で約66.7%になります。
1万個へ置き換えれば、A製6000個のうち不良60個、B製4000個のうち不良120個です。不良品180個のうち120個がB製なので、同じ120/180=2/3になります。Bの不良率3%をそのまま答えるのではなく、不良品を条件として出所を求めている点を確認します。
この問題で、Bの不良率がAの3倍だから、B製の確率は3/4とするのは適切ではありません。生産割合がAとBで異なるためです。それぞれの生産割合を掛けた不良個数で比べる必要があります。条件付き確率だけで結論を出さず、事前の割合を入れましょう。
「無作為に選ぶ」という条件も読み飛ばさないようにします。工場ごとに同数の検体を集めてから選ぶ場合など、抽出の仕方が違えば出所の割合も変わります。現実の製品の不良率を示す例ではなく、標本の取り方と分母を確認するための学習用の設定です。
基本情報のベイズの定理のまとめ
解く順番は、求める条件付き確率を文章と記号で書き、分類ごとの割合を確認し、同じ観測結果へ至る経路を掛けて足す、です。そのうえで、求める分類から来た経路を、観測結果の全体で割ります。公式の記号が変わっても、この順番は使えます。
追加の観測で確率を更新する場合は、その新しい観測の条件付き確率が必要です。同じ警告をもう一度眺めただけでは、新しい独立した証拠が増えたことになりません。複数の検査結果や単語を単純に掛ける場合も、独立性などの仮定を確認せずに進めないことが大切です。
例えば、Sという分類の下で二つの特徴が強く結び付いていれば、それぞれの出現確率の積が、同時に現れる確率になるとは限りません。ベイズの定理そのものが独立性を要求するわけではなく、複数の観測を簡単な積へ分解する部分に追加の仮定が入る、と区別します。
確率と利得を掛けて平均的な結果を考える問題は、基本情報の期待値の求め方で扱っています。ベイズの定理は、観測後の分類の確率を求める話です。問いが「平均の結果」か「条件付きの割合」かを先に確認すると、解き方を選びやすくなります。
まず、メールの表から180/670と20/9330の分母が異なる理由を説明してみてください。次に工場の例を式と件数で解き、両方が2/3になるかを照合しましょう。関連分野の演習は基本情報の過去問アプリでも進められます。ここで使った独自例題の収録を前提とした案内ではありません。
コメント