データマイニングは、蓄積したデータから役立つ規則や関係を見つけるための分析です。基本情報の学習では、売上を切り口別に集計するOLAPと区別し、何を出力したいかに注目すると、分類・回帰・クラスタリング・アソシエーションを整理できます。
この記事では、同じ店舗データでも分析目的によって手法が変わることを確認します。後半の自作例題では、支持度と確信度を計算し、矢印を逆にしたときに何が変わるかまで説明します。公式の過去問題を転載した記事ではありません。
- OLAPの集計とデータマイニングの規則発見の違い
- 分類・回帰・クラスタリングを出力と正解ラベルで選ぶ方法
- 8件の自作取引データで支持度と確信度を計算する手順
- 関連性を因果関係と取り違えず結果を読む注意点
基本情報のデータマイニングと分析手法
大量のデータから何を見つけるか
データマイニングの中心は、記録を保存することではなく、その中から判断に使えるパターンを取り出すことです。購入履歴から一緒に買われやすい商品を探す、過去の実績から次の売上を予測する、似た購買傾向の顧客をまとめる、といった目的が考えられます。
「大量のデータ」という言葉だけでは答えは決まりません。大量の注文を安全に保存することも、商品番号を高速に検索することもできます。問題文で見るべきなのは、データからどのような新しい判断材料を得ようとしているかです。規則・関係・予測モデルを得る説明なら、データマイニングの文脈とつながります。
IPAの基本情報技術者試験シラバスVer.9.2では、データ利活用の用語例にデータマイニング、アソシエーション分析、リフト値などが挙げられています。用語を一列に暗記するより、どの問いに答えるための考え方かを結び付けて学びましょう。
たとえば店舗の担当者が知りたいことを、「先月いくら売れたか」「来月いくら売れそうか」「どの商品が併買されやすいか」の三つに分けます。同じ購入履歴を使っていても、一つ目は実績の集計、二つ目は数値の予測、三つ目は商品の関係の発見です。分析対象が同じでも、分析の目的は同じではありません。
なお、「新しい知識」は、必ず世界で初めての発見という意味ではありません。分析対象の組織にとって、仕入れや案内方法を考える助けになるかが大切です。見つかった結果をそのまま真実と扱わず、データの範囲や偶然の可能性を確認するところまで含めて考えます。
OLAPやDWHとの違いを整理する
OLAPは、蓄積したデータを時間・地域・商品などの切り口で集計、比較するための分析処理です。データマイニングは、データにある関係や規則を見つけたり、予測に使うモデルを作ったりする文脈で使います。どちらも意思決定に役立ちますが、問題文が求める成果物に違いがあります。
| 用語 | 中心となる役割 | 学習用の店舗例 |
|---|---|---|
| DWH(データウェアハウス) | 分析用データを集めて蓄積・整理する | 複数店舗の販売履歴を分析用にまとめる |
| OLAP | 切り口や集計の細かさを変えて実績を見る | 月別・店舗別の売上を比較する |
| データマイニング | 規則・関係・予測モデルなどを得る | 併買されやすい商品や売上予測を調べる |
たとえば「全店舗の月間売上を店舗別の内訳へ掘り下げる」なら、既にある集計を詳しく見る操作が問われています。一方、「過去の購入履歴を調べ、ある商品を買うと別の商品も買いやすいという規則を得る」なら、商品の関連性を探す分析が問われています。単に詳しく見ることと、規則を見つけることを分けます。
ただし、現実の製品では一つの分析ツールが集計と予測の両方を備えることがあります。「OLAPのツールではデータマイニングが絶対にできない」といった製品全体への断定は不要です。基本情報の問題では、示された機能や操作が何をしているかに合わせて選びます。
また、DWHを使うことがデータマイニングの必須条件とは限りません。DWHは保管・統合する仕組み、データマイニングはそこから知見を得るための分析という、役割の違いを押さえれば十分です。OLAPの操作名まで確認する場合は、基本情報のOLTPとOLAPの違いと分析操作で集計の前後を確認できます。
分類と回帰は出力する答えで分ける
分類は、あらかじめ定義されたカテゴリのどれに当てはまるかを予測する課題です。たとえば、購入履歴と「キャンペーンに反応した・反応しなかった」という正解の組を使い、新しい顧客がどちらに入りそうかを予測します。求める答えはカテゴリです。
回帰は、金額や温度などの数値を予測する課題です。過去の天候、曜日、売上額を使って翌日の売上額を予測する例なら、求める答えは「何円か」です。分類と回帰は、入力に数字を使うかどうかで区別するわけではありません。年齢や金額を入力に使っても、答えが「購入する・しない」なら分類の課題です。
両者は、入力と正解の組から関係を学ぶ教師あり学習の代表的な課題です。正解として付いたカテゴリや数値を正解ラベル、予測に使う入力項目を特徴量と呼びます。IBMの分類と回帰の解説も、カテゴリの予測と連続した数値の予測を区別しています。
境界を確かめるには、同じ売上を別の形で答える二つの課題を考えましょう。「翌日の売上は何円か」を予測するなら回帰です。「翌日の売上は高・中・低のどの区分か」を予測するなら分類です。高・中・低の境界を先に定義し、その正解の区分を学習するものとします。扱う業務が同じでも、出力を変えると課題が変わります。
決定木は、条件による分岐をたどって予測するモデルで、分類にも回帰にも使えます。そのため「決定木という語があるから必ず分類」とは選べません。また、ロジスティック回帰は名称に回帰が入りますが、二値分類などに用いられます。手法名の一文字より、問題文が何を予測しようとしているかを優先してください。
分類の答えを便宜上0と1で表しても、0円や1円を予測する課題になったわけではありません。数字がカテゴリの符号なのか、大小や差を持つ予測値なのかを読むと、「数値が出るなら全部回帰」という誤りを避けられます。
クラスタリングは似た特徴で分ける
クラスタリングは、データ同士の似ている度合いを基にグループを作る分析です。どの顧客がどのグループに属するかという正解ラベルを与えず、購入回数や購入額などの特徴からまとまりを見つけます。教師なし学習の代表的な課題として整理できます。
例として、顧客を「年間の購入回数」と「一回当たりの購入額」で比べるとします。頻繁に少額を買う顧客のまとまりと、回数は少ないが高額を買う顧客のまとまりが見えたら、分析後にそれぞれの特徴を読み取れます。この例のグループ名は、最初から正解として与えたものではありません。
分類もクラスタリングも、日常語では「顧客を分類する」と表現されることがあります。見分けるときは、既知の正解カテゴリへ新しいデータを割り当てるのか、正解カテゴリを与えず似たデータのまとまりを作るのかを確認します。情報処理学会のデータマイニング解説でも、この違いを踏まえて分類とクラスタリングが整理されています。
「グループ数を三つと指定する」と書かれていても、ただちに教師あり学習になるわけではありません。個々の顧客の正解グループを与えることと、作るグループの数を設定することは別です。NISTのクラスタ分析資料にあるk-means法では、クラスタ数kを設定して似たデータをまとめます。グループ番号も、通常は優良・不良の順位を意味しません。
似ているかの判断は、使う特徴や尺度にも左右されます。購入額を円単位で表すか万円単位で表すかによって、距離をそのまま計算する分析では影響が変わり得ます。クラスタリングの説明に、特徴量の選択や標準化などの前処理がつながる理由はここにあります。
アソシエーションは組合せを探す
アソシエーション分析は、データの中で一緒に現れやすい項目の関係を探す分析です。店舗の一回の買物を一つの取引として扱い、「パンを買う取引ではミルクも買われやすい」といったルールを調べる例は、マーケットバスケット分析と呼ばれます。
ルールは「A→B」の形で表せます。Aを条件部、Bを結論部とすると、「Aが含まれる取引でBも含まれる傾向」を表します。この矢印は、Aを買った後に時間を置いてBを買うことを必ず意味するものではありません。ここでは同じ買物かごに含まれるかを扱います。
また、「Aが原因でBを買った」という因果関係を証明する矢印でもありません。たとえばパンとミルクが一緒に売れていても、朝食を買いそろえるという別の事情が共通して影響しているかもしれません。併買の傾向は販促案を考える手がかりになりますが、原因を断定するには別の検証が必要です。
分類や回帰が一件の対象について答えを予測する課題であるのに対し、バスケット分析では項目同士の組合せが中心になります。「購入するかを予測する」と「一緒に買われる商品を探す」は、買物という語が共通でも同じ課題ではありません。続いて、ルールを数値で読む支持度と確信度を計算します。
基本情報のデータマイニングを例題で解く
問題文の目的から手法を選ぶ
ここからは、この記事用に作成した学習用の例題です。まず、次の五つの処理を読み、どの手法や処理に当たるかを考えてください。実際の店舗の調査結果ではなく、判定の観点を練習するための設定です。
- 過去の顧客情報と退会した・しなかったという結果を学習し、新しい顧客の退会区分を予測する
- 過去の気温、曜日、売上額から、翌日の売上額を予測する
- 顧客の正解区分を与えず、購買の特徴が似た顧客をいくつかの群にまとめる
- 一回ごとの購入記録を使い、同時に買われやすい商品の組合せを見つける
- 月別売上の合計を、店舗別の内訳に掘り下げて表示する
答えは順に、分類、回帰、クラスタリング、アソシエーション分析、OLAPのドリルダウンです。名称だけで答え合わせを終わらせず、根拠となる語を一つずつ抜き出しましょう。最初は「退会区分」、二つ目は「売上額」、三つ目は「正解区分を与えず」、四つ目は「商品の組合せ」、五つ目は「集計の内訳」が手がかりになります。
| 確認する問い | 問題文の答え方 | 対応する課題 |
|---|---|---|
| 何円、何度などを予測するか | 数値を答える | 回帰 |
| 既知のどの区分へ入るか | 定義されたカテゴリを答える | 分類 |
| 正解を与えず似たものをまとめるか | データのまとまりを得る | クラスタリング |
| 一緒に現れる項目を探すか | 項目間のルールを得る | アソシエーション |
| 切り口を変えて実績を見るか | 集計表・比較結果を得る | OLAP |
読み間違いやすいのは「予測」と「分類」という日本語です。将来の退会区分も予測なので、「予測なら回帰」という選び方はできません。同じく「顧客を分類する」という文章でも、既知のカテゴリがあるか、類似度から群を作るかで手法が違います。最終的にどのような形の答えを得たいかを読みましょう。
さらに、「購入金額を使って顧客を分ける」だけでは情報が足りません。正解ラベルを学習するのか、似た特徴を基に群を作るのか、単に一定額以上を抽出するだけなのかを確認します。設問に書かれた処理を、勝手に機械学習の手法へ置き換えないことも大切です。
支持度と確信度は分母を確認する
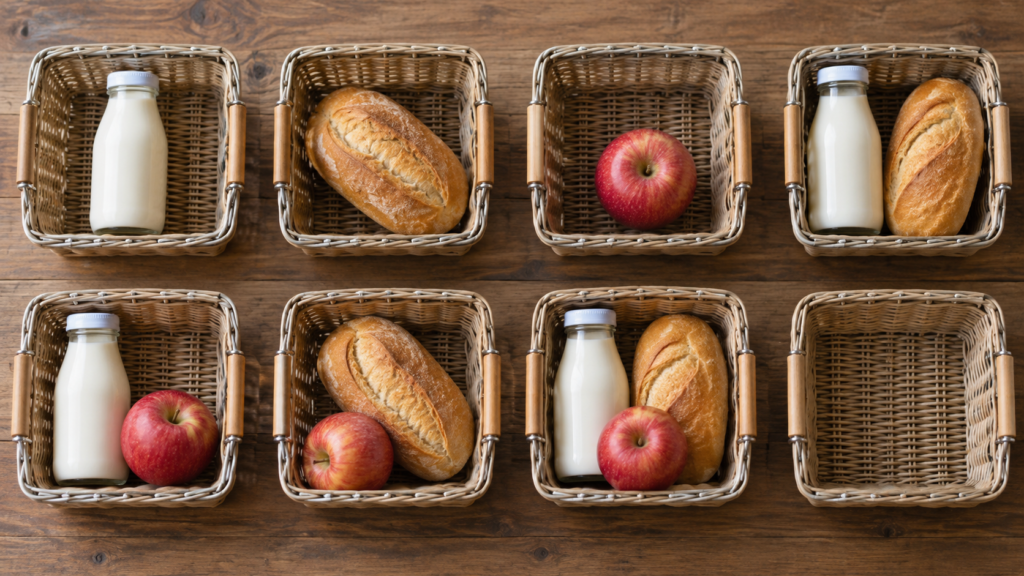
支持度と確信度を、8件の取引から計算します。1行が一回の買物で、同じ人が何回来店したかは考えません。商品の個数も数えず、その取引に商品が含まれるかだけを扱います。パンを二個買っても、パンを含む取引としては1件です。
| 取引番号 | 購入した商品 |
|---|---|
| 1 | パン、ミルク |
| 2 | パン、ミルク、りんご |
| 3 | パン、ミルク |
| 4 | パン、りんご |
| 5 | ミルク、りんご |
| 6 | ミルク |
| 7 | りんご |
| 8 | ミルク、りんご |
全取引は8件、パンを含む取引は1〜4の4件、ミルクを含む取引は1・2・3・5・6・8の6件です。パンとミルクの両方を含む取引は1・2・3の3件です。りんごを一緒に買った取引2も、パンとミルクの両方を含むので数えます。二つの商品だけを買った取引に限定するわけではありません。
「パン→ミルク」の支持度は、両方を含む取引数÷全取引数で求めます。この例では3÷8=0.375なので、37.5%です。「すべての買物の中で、パンとミルクの組合せがどれくらい現れたか」を表します。
「パン→ミルク」の確信度は、両方を含む取引数÷パンを含む取引数で求めます。この例では3÷4=0.75なので、75%です。「パンを買った取引に絞ると、その中でミルクも買ったのはどれくらいか」を表します。
| 指標 | 分子 | 分母 | この例の答え |
|---|---|---|---|
| 支持度 | パンとミルクの両方を含む3件 | 全取引8件 | 3÷8=37.5% |
| 確信度 | パンとミルクの両方を含む3件 | パンを含む4件 | 3÷4=75% |
この二つは分子が同じでも、分母の集団が違います。計算前に「全体のうちか」「パンを買った取引のうちか」を日本語で補うと、公式を丸暗記するだけより混乱しにくくなります。IBM公式マニュアルのアソシエーションルールの指標(PDFの59ページ)でも、ルール全体を満たす割合と、条件部を満たす取引に対する割合が区別されています。
誤りの例も確認しましょう。4÷8=50%はパンという単独項目の支持度で、「パン→ミルク」のルール全体の支持度ではありません。3÷6=50%は次の節で扱う逆向きの確信度です。答えがもっともらしい割合になっても、分母が何の件数かを照合しなければ正誤は判断できません。
逆向きのルールとリフトを読む
矢印を逆にして「ミルク→パン」を計算するとどうなるでしょうか。両方を含む取引は変わらず3件なので、支持度は3÷8=37.5%のままです。確信度の分母は、条件部であるミルクを含む6件になります。したがって3÷6=50%です。
「パンを買った取引の75%がミルクも買った」ことから、「ミルクを買った取引の75%がパンも買った」とは言えません。条件として選ぶ集団が違うからです。ミルクはパンなしでも買われているため、今回の設定では逆向きにすると確信度が下がります。矢印の前にある商品を先に丸で囲むと、分母を選びやすくなります。
確信度だけで関連の強さを判断しにくい場合もあります。今回、ミルクは全体の6÷8=75%の取引で買われています。パンを買った取引でもミルクの割合は75%です。高く見える確信度でも、全体の買われやすさと比べると割合は上がっていません。
この基準と比べる指標がリフトです。「A→B」のリフトは、確信度÷Bの支持度で求めます。今回の「パン→ミルク」は0.75÷0.75=1です。IBMのリフトの定義でも、条件部から得られる確信度を、結論部が全体で現れる割合と比べています。
リフトが1を超えるなら、Aを含む取引ではBの割合が全体より高い、1なら同じ、1未満なら低いと読みます。ただし、それだけで施策の効果や因果関係が確定するわけではありません。対象期間や件数、同時に起きた販売条件なども関係します。
追加練習として、全100件のうちAを含むものが20件、Bを含むものが40件、両方を含むものが12件の設定を考えてください。A→Bの支持度は12%、確信度は60%、リフトは0.6÷0.4=1.5です。逆向きのB→Aは確信度30%ですが、リフトは0.3÷0.2=1.5となります。支持度・確信度・リフトを、同じ数値の別名として覚えないようにしましょう。
前処理と評価で誤解を防ぐ
分析の手法が正しくても、入力の数え方がずれると結果は変わります。先ほどは「一回の買物を一取引」と定義しました。これを「一人の一か月分の買物を一取引」に変えると、別の日に買ったパンとミルクも同じ取引に入ることがあります。どの単位で関係を調べているのかを先にそろえる必要があります。
重複したレコード、商品名の表記揺れ、欠損値なども確認します。「ミルク」と「牛乳」を同じ商品として扱う設計なら名称の統一が必要です。一方、別の商品を勝手に一つへまとめれば、意図しない関係を作ってしまいます。前処理は何でも削除・統合すればよいのではなく、業務上の意味に合わせる作業です。
外れ値も、誤入力とは限りません。通常より大きい購入額が、本当に大量注文をした取引かもしれません。分析を邪魔する値に見えても、目的によってはそれ自体が注目すべき現象です。データの背景を確かめずに外れた値を全部消すと、知りたい情報まで失うおそれがあります。
学習したデータに対してうまく答えられても、別のデータで同じように予測できるとは限りません。学習用の細かな特徴や偶然に合わせすぎる過学習を避けるため、モデルの学習と評価に使うデータを分けて確認します。売上の将来予測なら、予測時点より後で分かる情報を入力に混ぜないことも大切です。
たとえば翌日の売上を予測するのに、翌日が終わって初めて分かる返品確定額を使うと、学習時だけ有利な条件になります。その数字を実際の予測時に利用できなければ、運用時に同じ方法で答えることはできません。AWSのデータ分割と情報漏えいの解説でも、予測時点で利用できない特徴を学習に混ぜる問題が示されています。「よく当たったか」だけでなく、「その時点で使える情報だけで確かめたか」を確認します。
バスケット分析も、少ない件数で確信度が高く出ることがあります。Aを買った取引が1件しかなく、その1件がBも買っていれば確信度は100%です。しかし、全体の何件で見られたのかを併せて見ないと、安定した傾向か判断できません。指標の高さと、根拠となる件数は分けて確認しましょう。
最後に、分析結果は業務の問いへ戻して読みます。併買のルールが出ても、陳列を変えると売上が増えるという実証結果ではありません。試験の選択肢でも、「関連が見つかった」から「原因が証明された」へ言い換わっていないかを点検すると、結果の過大解釈を見つけやすくなります。
基本情報のデータマイニングを復習する
基本情報のデータマイニングは、出力を先に決めると整理できます。既知のカテゴリを予測するなら分類、数値を予測するなら回帰、正解ラベルを与えず似たものをまとめるならクラスタリング、項目の組合せを探すならアソシエーションです。切り口を変えた実績の集計を問うOLAPとも分けて考えましょう。
計算問題では、まず一取引の単位と矢印の向きを確認します。支持度の分母は全取引、確信度の分母は条件部を満たす取引です。8件の例を見ずに「3÷8と3÷4の違い」を説明できたら、逆向きの3÷6、全体のミルクの割合6÷8まで続けて確認してみてください。
復習の順序は、目的の判定、件数の数え上げ、分母の選択、結果の解釈です。手法名だけを覚えて止まるより、どの語が答えの根拠か、別の選択肢はなぜ違うかまで一文で説明すると、理解があいまいな箇所を見つけられます。
この記事の自作例で区別がついたら、基本情報の過去問演習アプリで科目A・科目Bの演習へ進めます。解答後は正誤だけでなく、問題文が求める出力と、計算式の分母を自分の言葉で確認してみてください。
コメント