基本情報のレプリケーションは、データベースの複製を別のサーバーなどに持たせ、元の更新を複製先へ反映する仕組みです。障害への備えや読み取り負荷の分散に役立ちます。ただし、複製があるだけで最新データの保全や無停止を保証できるわけではありません。
同期と非同期は、「利用者に更新成功を返す前に、複製先のどの確認を待つか」で区別すると分かりやすくなります。さらに、受信したこと、消えないよう保存したこと、検索結果に反映したことを分けると、遅延や障害時の選択肢も判断できます。
この記事では、注文データの時系列と自作例題で、同期・非同期、切替え、バックアップとの違いを整理します。時刻や注文番号は学習用の仮定で、実際の障害事例や特定製品の性能値ではありません。
- 複製を持つ目的と、切替えの仕組みを分けて理解する
- 同期・非同期を成功応答と確認の順序で見分ける
- 遅延と障害時刻から複製先に残るデータを判断する
- 誤削除への備えをバックアップと区別する
基本情報のレプリケーションと同期方式
複製元と複製先は何を共有するのか
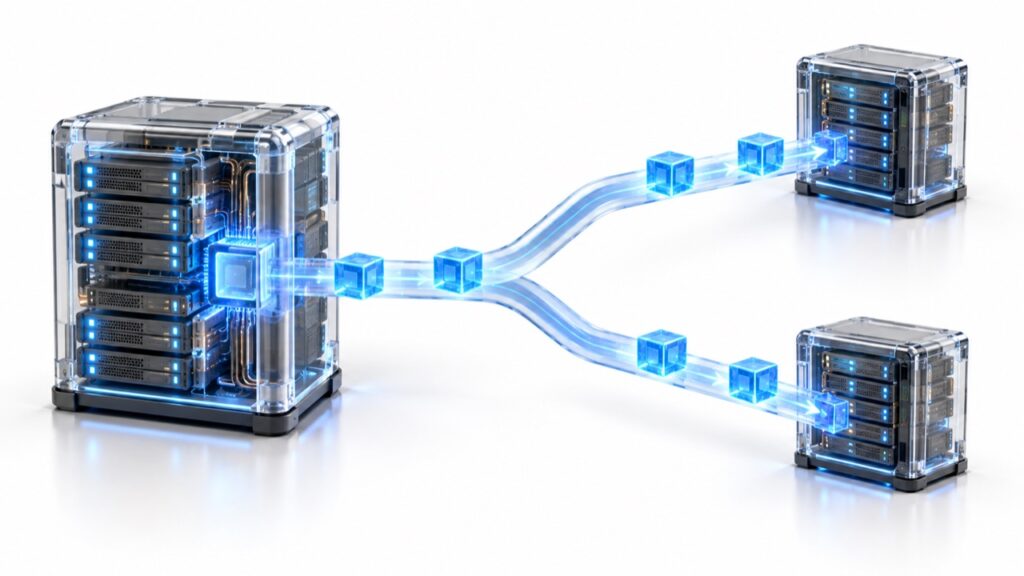
レプリケーションで作る複製をレプリカと呼びます。ここでは、更新を受け付ける複製元をプライマリ、更新を受け取る複製先をレプリカとします。教材によってはマスターとスレーブという呼び方もありますが、まずはデータをどちらからどちらへ送る構成なのかを確認しましょう。
例えば、注文番号101をプライマリへ登録すると、その変更をレプリカにも伝えます。次に注文番号102を登録すれば、その変更も伝えます。最初に一度コピーして終わるのではなく、運用中に生じる追加・変更・削除を、対象範囲と方式に応じて反映していく点が中心です。
送るものは必ずしもデータベースの全ファイルそのものではありません。例えば、変更を記録したログを送って複製先で再現する方式があります。物理的なデータの変更を扱う方式と、表の行などの論理的な変更を扱う方式も区別されます。「複製」は共通する目的であり、転送の単位や対象範囲まで全製品で同じではありません。
PostgreSQL公式の複製方式の比較でも、ログを送る方式と論理レプリケーションなどを分けています。基本を学ぶ段階では、設定名を覚える前に「元の変更を別の場所にも保持する」と捉えると、その後の同期方式につながります。
なお、表を用途別に分けたり、重複する項目を整理したりするデータ設計とは役割が違います。データベース全体の位置づけを復習したい場合は、基本情報のデータベースの基礎解説も参照できます。本記事では複製と更新の伝わり方に絞って考えます。
可用性の向上と読み取り負荷の分散に役立つ
複製を別のサーバーに持つ目的の一つは、プライマリが故障したときに、別のデータの持ち主を利用できるようにすることです。サービスを使い続けやすくする性質を可用性と呼びます。元の装置にしかデータがなければ、その装置を修復するまで利用できない場面でも、複製先を活用する余地が生まれます。
もう一つは、対応する構成で読み取りをレプリカへ振り分けることです。注文の登録はプライマリ、商品情報の閲覧や集計の一部はレプリカ、というように役割を分ければ、読み取りが一台へ集中する状態を和らげられます。ただし、レプリカで参照を受け付けられるかどうかは、製品や設定によって異なります。
ここから「レプリカを二台にすれば更新も二倍速い」とは言えません。一台のプライマリに更新を集める構成では、更新処理の集中は残ります。変更を送る通信、ログの保存、複製先での適用にも資源を使います。読み取りの分散と、更新処理そのものの高速化を混同しないことが大切です。
また、同じ建物で同じ電源を使う二台は、電源障害で同時に停止する可能性があります。別の場所へ複製すれば障害の範囲を分けやすくなりますが、遠い場所との通信には遅延や切断への配慮が必要です。複製の有無だけで判断せず、何の故障を想定した配置なのかまで読むと、構成の狙いをつかめます。
同期と非同期は成功応答の前後関係で見分ける
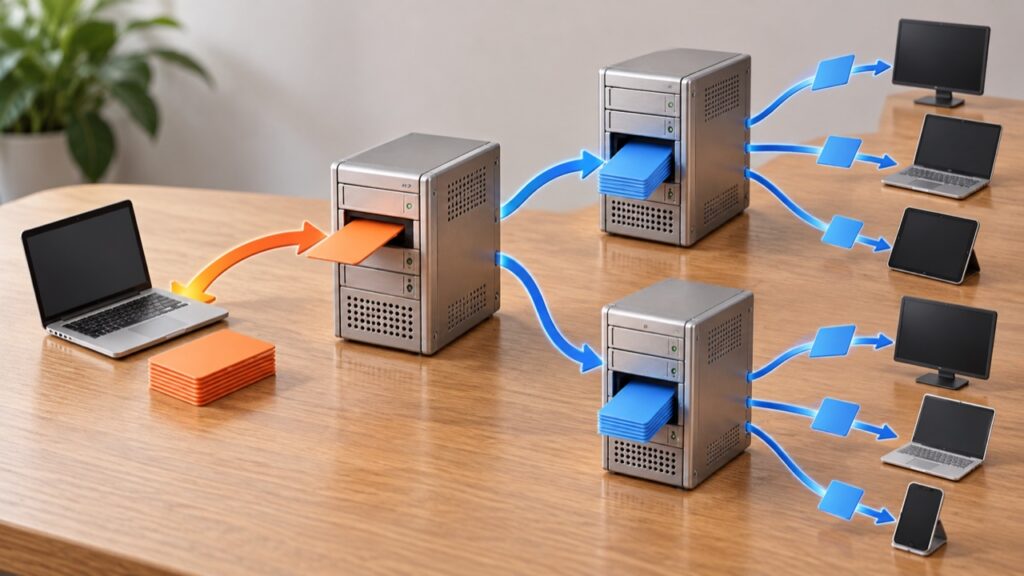
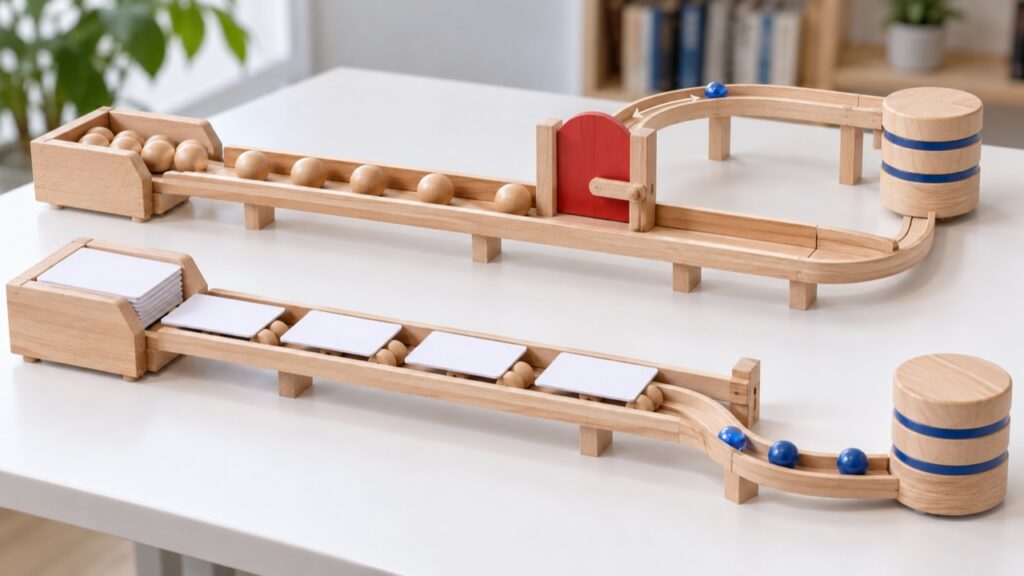
同期レプリケーションは、必要な複製先から所定の確認を得てから、更新の成功を利用者へ返す方式です。プライマリ内だけで処理が終わっても、必要な確認が戻らなければ待ちます。何を確認するか、何台の確認を要求するかは構成によって決まります。
非同期レプリケーションでは、その更新について複製先の確認を成功応答の条件にしません。例えば、プライマリで必要な保存を終えた時点で成功を返し、複製先への反映は独立して進めます。転送が成功応答より前に始まる場合もあるため、「必ず返信してから送信を始める」と順番を固定する説明は正確ではありません。
判定の軸は、実際にたまたま複製が先に終わったかどうかではなく、成功を返すために複製先の確認が必要かです。非同期でも、通信と処理が順調なら応答のころには複製が追いついていることがあります。それでも、確認を待つ契約でなければ同期方式とは呼べません。
| 見る項目 | 同期 | 非同期 |
|---|---|---|
| 成功応答の条件 | 必要な複製先からの確認を含む | 複製先からの確認を条件にしない |
| 複製先が遅い場合 | 成功応答を待たせる要因になる | 応答を返した後も反映が遅れ得る |
| 主に確認する点 | どこまでの確認を何台から待つか | 未反映の量と、切替時に失い得る更新 |
| 共通の注意 | 確認対象外の障害まで防ぐわけではない | 常にデータを失うわけではない |
単に「同期は安全、非同期は速い」と覚えるより、問題文の「複製先の保存完了を待って応答する」という条件に線を引く方が確実です。後者の応答時間も、プライマリや回線の混雑に左右されるので、どんな環境でも必ず速いという保証ではありません。
受信・永続化・適用の三段階を区別する
複製先へデータが届く過程には、複数の段階があります。まず変更の記録を受信し、その内容を消えないよう保存し、データベースへ適用します。永続化とは、単にメモリにある状態と区別して、障害後にも保持できるようにすることです。受信したという連絡だけでは、どの障害まで耐えられるかを判断できません。
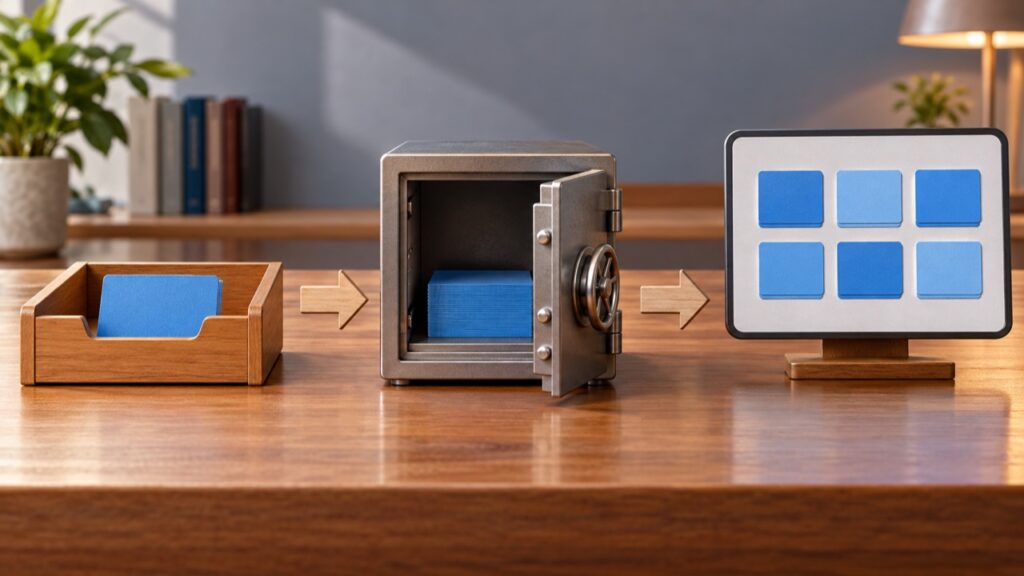
さらに、ログを永続化したことと、利用者の検索に新しい結果が見えることも別です。複製先に注文番号101のログが保存されていても、まだ適用処理が進んでいなければ、レプリカの注文一覧に101が現れない場合があります。保存済みのログを後で適用して回復できることと、その瞬間に読めることを分けましょう。
具体的な実装差として、PostgreSQL公式の同期コミット設定には、同期対象が設定されているとき、複製先での永続化を待つ設定と、適用されて参照可能になるまで待つ設定があります。同期という名前だけから、全レプリカですぐ検索できると断定してはいけない理由です。
試験の設問で「複製先への書込み完了を待つ」と条件が明示されていれば、その条件に従います。製品マニュアルの細かな設定を勝手に持ち込む必要はありません。一方、条件のない実システムについて「同期だから読み取り遅延は絶対にない」と広げるのも避けます。抽象的な方式の説明と、個別実装の保証範囲を区別するのがコツです。
遅延は通信だけでなく複製先の処理でも生じる
レプリケーション遅延は、プライマリの更新に対してレプリカが追いついていない差です。更新が送られるまでの待ち、通信で届くまでの時間、受信した変更を保存・適用する時間などが関係します。複製用の回線が正常でも、複製先の処理が追いつかなければ、参照できるデータの時点は遅れます。
例えば、レプリカが一秒に80件の変更を適用できると仮定します。同じ大きさの変更がプライマリで一秒に100件発生し、その状態が10秒続けば、適用待ちは単純モデルで200件増えます。その後の発生が一秒40件になれば、余力は一秒40件なので、200件を解消するにはさらに5秒かかります。これは処理能力と発生量だけを使った自作の概算で、製品性能の説明ではありません。
この例で見るべきなのは、回線を速くしても適用能力が80件のままなら、100件発生している間の待ちは解消しない点です。転送待ちなのか、到着後の適用待ちなのかによって、改善する場所が変わります。PostgreSQL公式のレプリケーション監視の説明も、送信・受信・適用の位置を区別して確認しています。
時間で表す遅延と、未処理の件数やバイト数も同じものではありません。一秒に生じる変更量が異なる二つの業務では、同じ三秒の遅延でも未反映データの量は異なります。「遅延三秒だから注文が三件ない」とは計算できず、必要なら更新の発生時刻や件数を確認します。
何を優先するかで同期方式を選ぶ
同期方式を選ぶ場面では、成功と伝えた更新を複製先にも確実に保持したいという要件が重視されます。その代わりに、必要な確認を待つ時間が応答へ加わります。離れた拠点との往復や複製先の負荷が大きければ、利用者の待ち時間に影響し得ます。
必要な複製先と通信できなくなった場合も、判断が必要です。確認条件を厳格に守るなら、新しい更新の成功応答を待たせる状況になります。応答を優先して確認条件を変える構成なら、その間の保全条件も変わります。製品や運用方針によって扱いが異なるため、「同期でも通信が切れたら自動で同じ安全性のまま続く」とは考えません。
非同期は、複製先の確認を待たずに応答できることが利点です。その代わり、障害時に複製先へ渡っていない更新が残り得ます。失ってよいデータの範囲、遅延の監視、障害時の照合方法を組み合わせて考えます。方式の優劣を一つに決めるのではなく、応答と保全のどちらにどんな条件を置くかを読む問題なのですね。
基本情報のレプリケーションを時系列で解く
非同期の例題は障害までに届いた注文を追う
非同期レプリケーションを使う注文システムを考えます。初めは両方に注文100まで保存されています。以下では、表に書いたレプリカへの保存が永続化を意味し、プライマリは障害後にデータを取り出せず、ほかの保存先もないと仮定します。レプリカに保存したログは、切替えの前に必要な適用を行えるものとします。
| 時刻 | プライマリと利用者への応答 | レプリカの状態 |
|---|---|---|
| 10:00:00 | 注文101を保存し、成功と応答 | 注文100まで保存 |
| 10:00:02 | 稼働中 | 注文101まで保存 |
| 10:00:03 | 注文102を保存し、成功と応答 | 注文101まで保存 |
| 10:00:04 | 故障し、データを取り出せない | 注文102は未受信 |
この条件でレプリカを使って再開する場合、注文101は復元できますが、102は復元できません。利用者には102の成功を伝えていても、その記録を持つプライマリを失い、レプリカにも届いていないためです。成功応答の記録と、切替先が保持する記録にずれが生じる例です。
ここで「非同期だから101も102も失う」と答えるのは誤りです。101は既にレプリカへ保存されています。反対に「複製しているから102も必ず残る」とするのも誤りです。方式名だけで結果を決めず、障害時点で各更新がどこまで進んだかを一件ずつ追う必要があります。
障害時刻を10:00:01へ変えると、表の条件では101もまだレプリカへ保存されていません。逆に、102をレプリカへ保存してから故障したという条件なら、102も残せます。同じ非同期方式でも結果が変わるので、例題を解くときは、まず障害の縦線を引き、その左側で完了した保存だけを拾いましょう。
同期の例題は何を確認して成功を返したかを見る
次は、レプリカ一台での永続化完了を待って成功応答を返す同期方式を考えます。プライマリが注文201を保存し、レプリカがそのログを永続化し、確認がプライマリへ戻ってから利用者に成功を返したとします。その直後にプライマリだけが故障し、レプリカとその記憶装置は正常に残りました。
この場合、成功済みの注文201を回復するための記録はレプリカにもあります。非同期の例との違いは、単に転送が速かったことではなく、レプリカでの保存を成功応答の必須条件にしていたことです。ただし、保存したログを適用し、レプリカを新しい更新先として利用できるようにする作業は別途必要です。
そのため「201は保持できる」と「故障直後から待ち時間なしで全操作を再開できる」は別の判断になります。データが残っていても、障害の検出や切替えには時間がかかり得ます。さらに、プライマリとレプリカの保存装置が両方壊れるといった条件は、この一台の故障への保証範囲から外れます。
途中で通信が切れ、利用者が成功応答を受け取れなかった場合も、「注文は確実に保存されていない」とは断定できません。サーバー側で保存が進んだ後に応答だけ届かなかった可能性があるからです。この場合は成功確認ができた更新と、結果が未確定の更新を分けます。応答の未受信を、そのまま全処理の取消しと読み替えないことが大切です。
更新直後の読み取りは接続先も確認する
利用者が登録成功を見た直後に注文一覧を開いたのに、新しい注文が表示されない場面を考えます。書込みはプライマリ、一覧表示はレプリカを使い、後者の適用が遅れているなら、同じ利用者が続けて操作しても古い結果を読むことがあります。これは、登録した情報を自分がすぐ読めるかという問題です。
先ほどの注文102を例にすると、10:00:03にプライマリが成功応答を返し、10:00:03.5にレプリカへ問い合わせても、そこが101までしか適用していなければ102は出ません。この時点ではプライマリが正常かもしれないため、表示されないことだけを理由に「登録データが消失した」と結論付けることもできません。
一般的な対処の考え方には、更新直後の確認はプライマリへ問い合わせる、必要な更新がレプリカへ適用されたことを確認してから読む、といったものがあります。どちらも接続先や待ち方の設計です。同期方式でも永続化までしか待たない条件なら、適用完了を待つかどうかを追加で確認します。
問題文の「複製先で検索した」「更新直後に参照した」という部分は、判断に必要な条件です。すべてを一台で処理しているつもりで読むと、保存したのになぜ見えないのかが分からなくなります。書込み先、成功応答の条件、読取り先の三点をメモしてから、データの状態を追うと整理できます。
複製だけではフェイルオーバーは完成しない
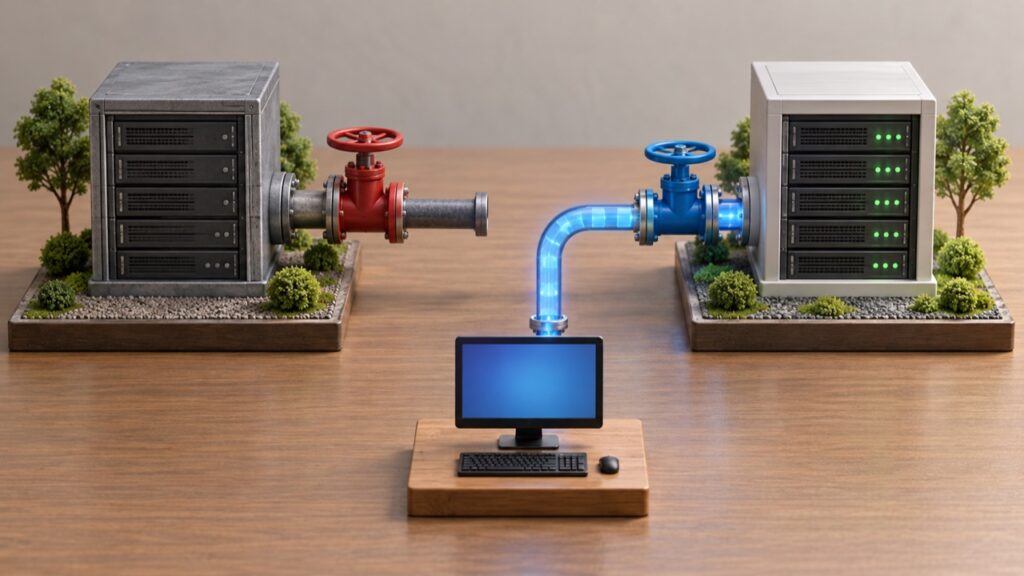
障害時に、稼働中の役割を別のサーバーへ切り替えることをフェイルオーバーと呼びます。レプリケーションは切替先のデータを用意する仕組みですが、障害を見つけること、どのレプリカを使うか決めること、接続先を変えることまで自動的にすべて実現するとは限りません。
切替えの前には、使うレプリカがどこまで更新を受け取っているかを確認します。複数あるうちの一台だけが同期確認の対象なら、別の遅れた一台へ切り替えても同じ保全条件になるとは言えません。「同期レプリカが存在する」と「今回の切替先がその同期レプリカである」を区別します。
通信障害でプライマリが見えなくなっただけの場合には、プライマリがまだ更新を受け付けている可能性もあります。この状態で別のサーバーにも同じ役割を与えると、双方で異なる更新が進むおそれがあります。元の更新先を止めるなど、同時に二つが独立した正本にならないための制御も、切替えの設計に含まれます。
基本の選択問題では、「複製を作って可用性を高める」という説明は妥当でも、「どんな障害でも必ず無停止で切り替わる」という説明は条件を広げすぎています。構成図に複製の矢印があれば、次に接続先を変える仕組みと、更新を受け付ける役割を探すと、機能の違いが見えてきます。
バックアップとの違いは誤削除が伝わる例で考える
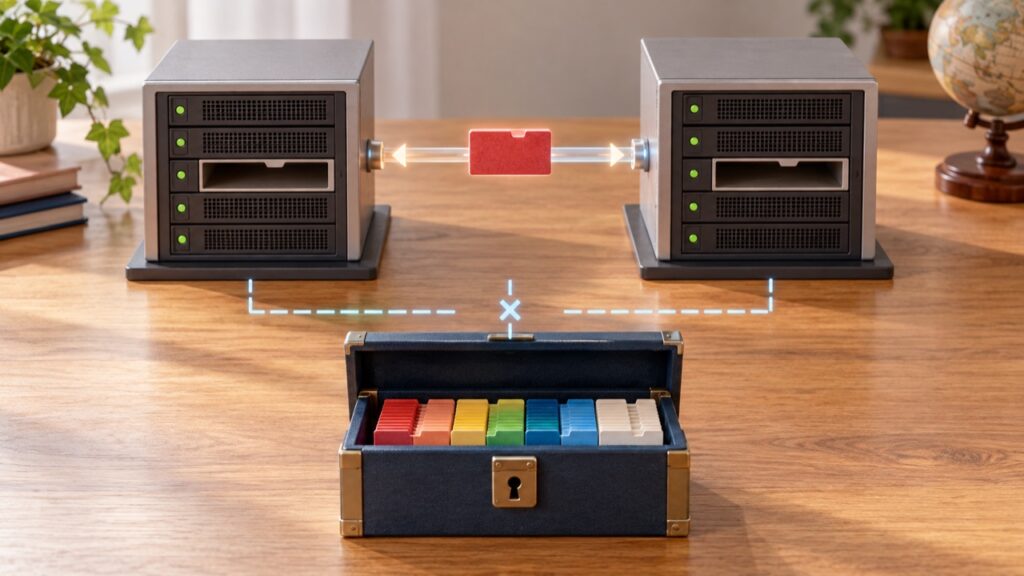
レプリケーションは運用中の変更を複製先へ追従させる仕組み、バックアップは復旧に使うデータを保持する備えです。実際の製品には両方の機能を組み合わせたものもありますが、単に最新状態へ追従するレプリカと、過去へ戻すために保持した復旧用データは役割が違います。
例えば、11:00に担当者が誤って注文データを削除し、その削除が通常の更新として複製されたとします。11:01にはプライマリとレプリカの両方から消えているかもしれません。二台が同じ状態であることは、二台とも正しい状態であることの証明にはなりません。
このとき、削除前の状態を回復できるバックアップと必要なログが別に保持されていれば、戻す手段になります。PostgreSQL公式の継続的アーカイブと時点復旧の説明には、ベースバックアップとログを使い、途中の時点まで再生して回復する考え方が示されています。バックアップは一日に一回だけ、と決まっているわけではありません。
| 比較する点 | 最新状態に追従するレプリカ | 過去の復旧用データを保持するバックアップ |
|---|---|---|
| 主な役割 | 別系統で運用や切替えを支える | 必要な状態への復旧を支える |
| 誤削除が起きたら | 削除も反映され得る | 削除前の復旧用データがあれば戻せる可能性がある |
| 確認する条件 | 同期方式・遅延・切替先 | 保持時点・必要なログ・復元可能性 |
| 代用の可否 | 単なる追従だけでは過去状態の保持を代用しない | 保管しただけでは稼働中の切替先を代用しない |
意図的に適用を遅らせるレプリカや、スナップショットを併用する仕組みもあります。しかし、そうした追加条件のない「レプリカがある」という説明から、過去の任意の時点へ戻せると推測してはいけません。バックアップの種類と復元に必要な組合せは、フル・差分・増分バックアップの違いで確認できます。
復旧の目標と方式そのものを混同しない
障害対策では、どれだけ早くサービスを再開したいか、どの時点までのデータを残したいかという目標も決めます。レプリケーションは、それを実現する手段の一つです。「同期レプリケーションを導入した」という方式の説明と、「停止を何分まで許す」という業務上の目標は、同じ項目ではありません。
例えば、成功済みの注文を複製先に保持できても、障害検出に五分、切替えに十分かかれば、利用者が再開を待つ時間は残ります。反対に、すぐ切り替えられても、非同期で最新の注文が複製されていなければ、データ面の条件を満たさないことがあります。再開の早さと、残るデータの新しさを分けて確認します。
目標を表すRTOとRPOの詳しい読み分けは、RTOとRPOを時系列で理解する解説にまとめています。本記事の例題で「102がない」と分かった後、その欠落が許される業務条件かどうかを判断するのは、次の段階です。
自作チェック問題で条件の読み方を確認する
問一です。「複製先の確認を待たず、プライマリで保存を終えたら成功応答を返す。応答の時点で複製先も偶然保存を終えていた」。これは同期でしょうか、非同期でしょうか。答えは非同期です。偶然の結果ではなく、成功応答の条件に複製先の確認が入っていないことが判断の根拠になります。
問二です。「同期対象のレプリカでログの永続化を確認した後、成功応答を返した。しかしレプリカの一覧画面には直後の注文が出なかった」。この説明は必ず矛盾するでしょうか。答えは、必ずしも矛盾しません。永続化の確認までを条件とし、適用処理がまだ済んでいなければ、保存できていても参照結果への反映は遅れ得ます。
問三です。「プライマリの誤削除がレプリカにも反映されたので、レプリケーションの故障である」。この説明は妥当でしょうか。削除を反映する対象とする正常な構成なら、答えは妥当ではありません。複製処理は変更を伝える役割を果たしています。過去へ戻す備えが必要という問題と、複製機能の故障は区別しましょう。
問四です。「同期対象ではないレプリカに切り替えるので、別の同期レプリカで確認済みの全更新も必ず残る」。答えは条件不足です。切替先自身がどこまで保持しているかを確認しなければなりません。構成内に最新の一台があっても、それを利用しなければ同じ結果にはならないという点を押さえます。
これらは仕組みを確かめるための自作問題で、IPAの実際の過去問を再現したものではありません。解説を隠して「応答条件」「保存地点」「読む地点」を自分の言葉で説明してから答えると、用語の丸暗記になりにくくなります。続けて演習したい場合は、基本情報の過去問演習アプリで科目や分野を選び、学習を進められます。
まとめ:基本情報のレプリケーションの要点
レプリケーションは、データを別の場所にも複製し、可用性の向上や対応する構成での読取り分散を支える仕組みです。同期と非同期の違いは、利用者に成功を返すとき、必要な複製先からの確認を条件にしているかどうかです。
例題を読むときは、最初に更新先と複製先を書き、次に成功応答の条件と障害時刻を置きます。その時刻までに受信・永続化・適用のどこまで進んでいたかを確かめれば、残るデータと、直後に参照できるデータを分けて判断できます。
誤削除も複製され得るため、最新状態への追従だけでバックアップの役割は満たせません。また、複製の存在と切替えの完成も別です。「何を待つか」「どの一台を使うか」「どの時点へ戻すか」を具体的に読むことが、基本情報の関連問題を整理する手掛かりになります。
コメント