基本情報のパイプライン処理は、複数の命令を別々の工程で同時に進め、単位時間に完了する命令を増やす仕組みです。1命令が通る工程を省くわけではありません。「1命令の開始から完了まで」と「複数命令がすべて終わるまで」を分けると、図も計算式も読みやすくなります。
停止のない単純なモデルでは、ステージ数をD、命令数をN、1ステージの時間をPとすると、全体の処理時間は(D+N−1)×Pです。最初の命令にはDステージ分、その後のN−1命令には1ステージ分ずつかかる、と考えます。
この記事では4段の時刻表から仕組みを確認し、サイクル数・ナノ秒の計算、ストールと3種類のハザードまでつなげます。例題は理解を確かめるためのオリジナルで、特定の実機の性能や現在の試験での出題頻度を示すものではありません。
- 最初の命令が終わる時刻と、その後の完了間隔の違い
- 時刻表から必要サイクル数を読み取る方法
- 公式を使える条件と、停止がある場合の補正
- 構造・データ・制御ハザードを原因で区別する見方
基本情報のパイプラインの仕組み
命令を工程に分けて重ねる
CPUが命令を処理するときは、命令を取り出し、内容を解読し、演算を行い、結果を保存するなどの作業が必要です。この作業をいくつかの工程に分けたものがステージです。ここでは理解用に、命令取得F、解読D、実行E、結果格納Wの4段モデルを使います。
F・D・E・Wという文字は、その命令が今どの工程にいるかを表します。後で計算式に使うDは「ステージ数」という数値なので、解読ステージを表すDと混同しないようにしましょう。問題文がk、n、tなど別の記号を使っていても、意味が同じなら計算の考え方は変わりません。
| 工程 | ここでの役割 | 次の工程へ渡すものの例 |
|---|---|---|
| F:命令取得 | 実行する命令を読み出す | 取得した命令 |
| D:解読 | 命令の意味や使うデータを確認する | 処理の指示や入力値 |
| E:実行 | 指定された演算を進める | 計算結果 |
| W:結果格納 | 結果を保存する | 後続命令が使える結果 |
パイプラインなしで1命令ずつ処理するなら、命令AがWまで終わってから命令BのFを始めます。ところが、AがDに移った時点でFの装置が次の命令を扱えるなら、BのFを先に進められます。AとBは同じ工程を取り合わず、別の工程で同時に動くわけです。
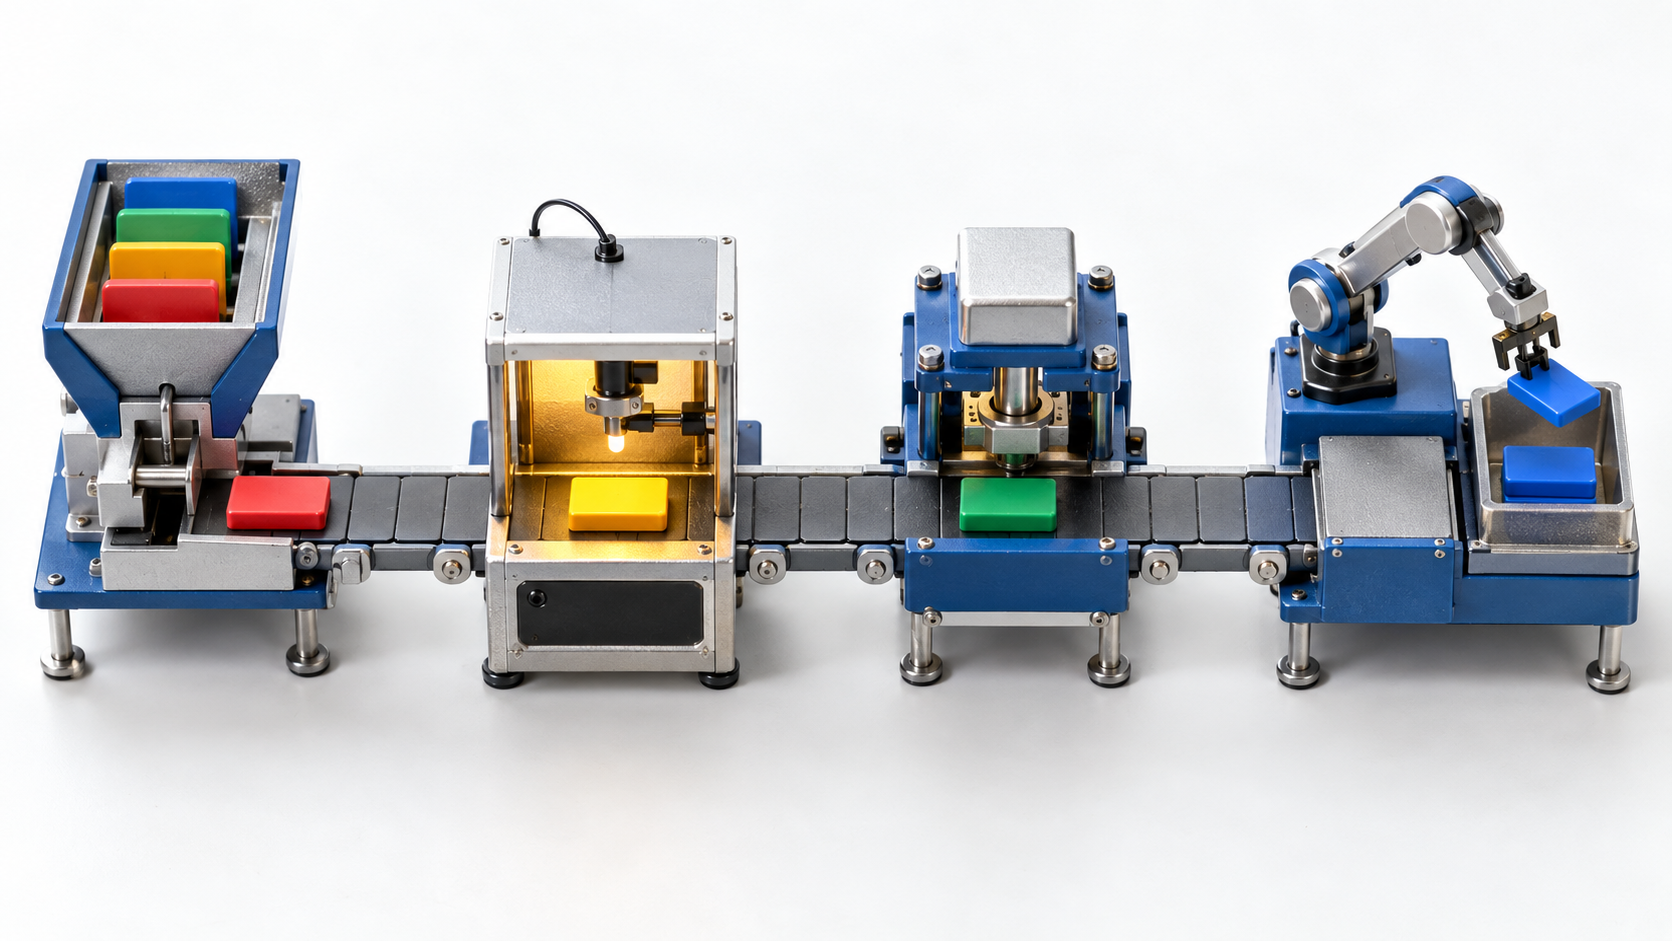
工場で「材料の準備・組立・検査・梱包」を別の担当が進める場面を考えると、重なりを想像できます。1個目を梱包している間に2個目を検査し、3個目を組み立てるので、完成品を継続的に送り出せます。ただし、担当が1人ですべてを順番に行うなら、工程名を分けただけでは同じ効果は得られません。
CPUにも、別の命令の工程を並行して進められる回路や、工程の間で中間結果を保持する仕組みが必要です。ステージの区切り方や段数は設計により異なります。教材の4段や5段を見て「すべてのCPUが同じ工程数」と覚えるのではなく、その問題で指定されたモデルを使ってください。
工程の原理と4段モデルは、琉球大学の「命令パイプライン I」で確認できます。以下の時刻表は、この原理を説明するために本記事で作成した例です。
時刻表は横と縦で読み分ける
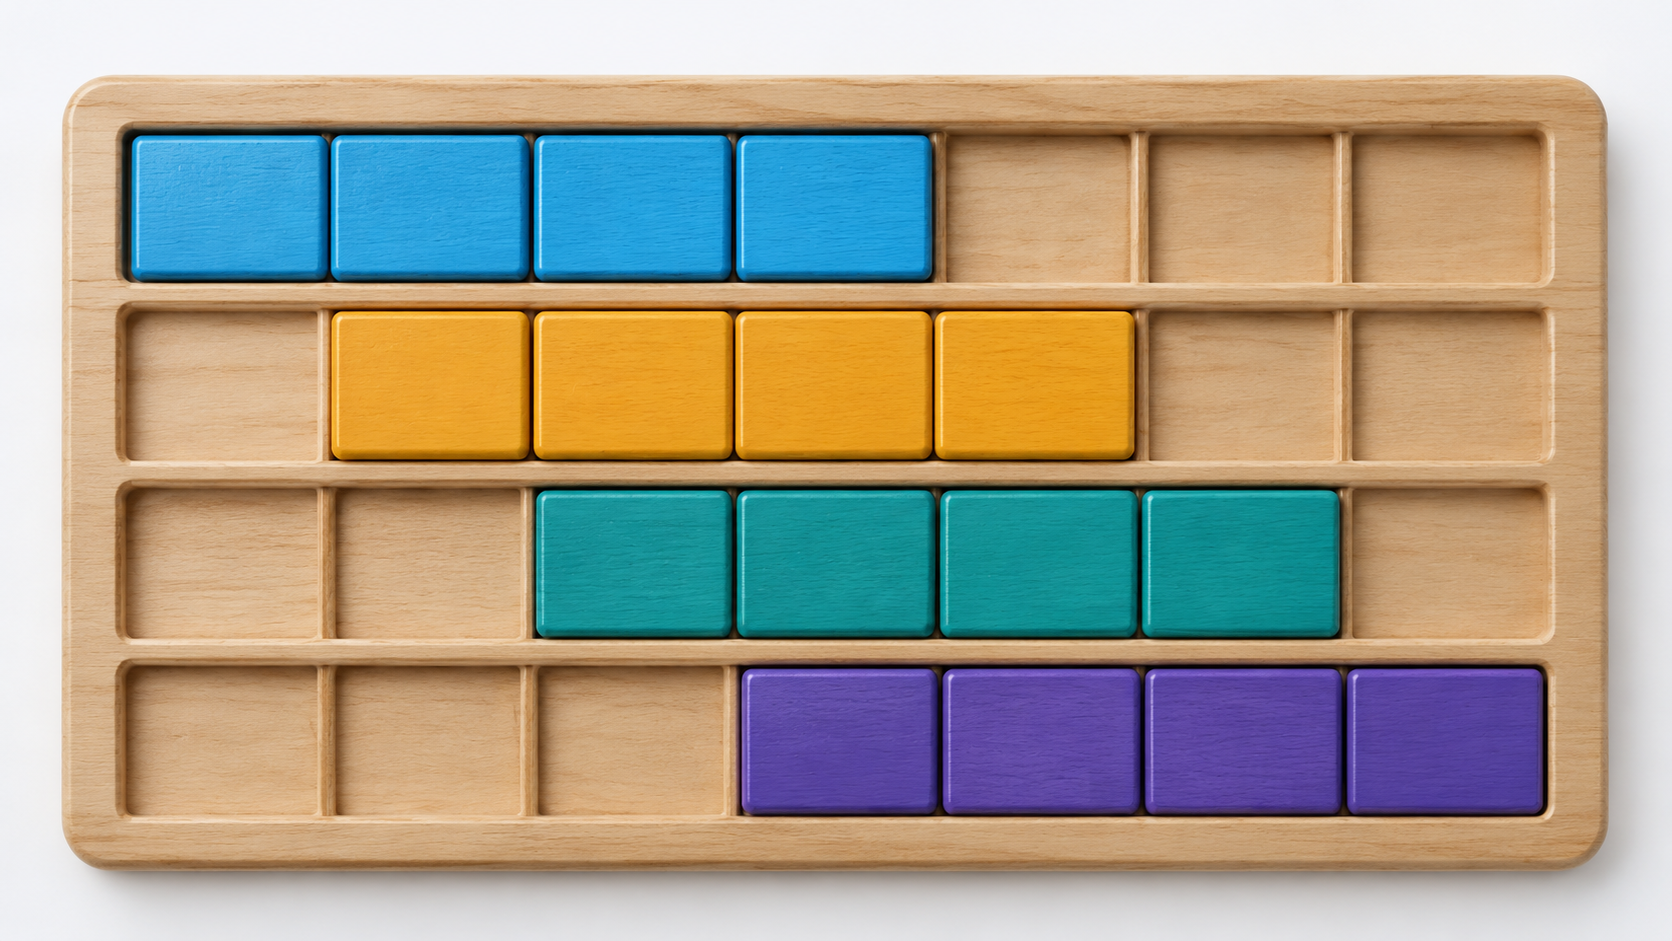
次の表は、4命令A〜Dを4段パイプラインに流す例です。すべての工程は1サイクルで終わり、毎サイクル1命令を開始でき、途中の停止はないと仮定します。表の列は時間、行は命令で、「—」はその命令の開始前または完了後を表します。
1サイクルは、表の1列に対応する時間区間です。サイクル1の開始を時刻0とすると、Aはサイクル4の終わりに完成します。列番号と時刻の境界を混ぜないことが、計算で1つずれるミスを防ぐ最初のポイントになります。
| 命令/サイクル | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| A | F | D | E | W | — | — | — |
| B | — | F | D | E | W | — | — |
| C | — | — | F | D | E | W | — |
| D | — | — | — | F | D | E | W |
横方向にAの行を追うと、F→D→E→Wと順番に進み、4サイクルかかっています。Bも開始は1サイクル遅いものの、命令自体が通る工程は同じです。「重ねたからBは3工程で済む」とは読みません。
縦方向にサイクル4の列を見ると、AはW、BはE、CはD、DはFにいます。4命令が同時に存在していても、4命令が同時に完成するわけではありません。この列で完成するのはAだけです。完成はA、B、C、Dの順に1サイクルおきに起こります。
全命令の処理時間を知りたいときは、左上のFの開始から、右下の最後のWの終了まで数えます。F・D・E・Wの記載されたセルをすべて足すと16個ありますが、それは工程の作業量です。重なりがあるため、経過時間は16サイクルではなく7サイクルになります。
図を自分で書くなら、まず1命令目に4つの工程を横並びに置きます。2命令目は右へ1列、3命令目はさらに1列ずらしてください。最後の命令の最終工程まで列を伸ばせば、短い問題でも暗算に頼らず答えを確認できます。
所要時間とスループットの違い
1命令の開始から完了までの時間をレイテンシと呼びます。一方、スループットは単位時間に完了する命令の数です。パイプラインの主な効果は後者にあり、1命令の工程を通過する時間が必ず短縮するという意味ではありません。
4段・1段10nsの例では、停止がない1命令のレイテンシは40nsです。パイプラインが十分に埋まった後は、10nsごとに次の命令が完成します。したがって定常状態の完了間隔は10nsですが、どの命令も開始から完成までは4段分かかります。
| 知りたいこと | 4段・1段10nsの答え | 数える対象 |
|---|---|---|
| 1命令が通過する時間 | 40ns | 同じ命令のFからWまで |
| 埋まった後の完了間隔 | 10ns | 隣り合う命令の完成時刻の差 |
| 4命令全体の処理時間 | 70ns | 最初のFから最後のWまで |
| 4命令の平均処理量 | 4÷70ns | 完成数を全体時間で割る |
この例で定常状態のスループットを秒単位に直すと、1÷(10×10の−9乗)=1億命令/秒です。一方、4命令だけを空の状態から流した平均は、4÷(70×10の−9乗)≒5,714万命令/秒になります。命令数が少ないと、最初に結果が出るまでの時間が平均値に大きく影響します。
「1サイクルで1命令」という説明を見たときは、工程が十分に重なった状態での完成数を述べているのか確認しましょう。1命令が1サイクルだけでFからWまで通過する、と解釈すると、工程図と矛盾します。開始時刻・完成時刻・完成間隔の3つを分けて書くと整理できます。
また、パイプラインの段数を増やすと、1段の作業を細かく分割できる一方、段の間で結果を受け渡す手間も増えます。レイテンシや実際の処理量は設計条件に左右されるため、実機について「深いほど必ず速い」と断定することはできません。ここでの計算は、与えられた段数と周期が一定のモデルに限定します。
性能を「時間」と「処理量」に分ける考え方は、Cornell大学の性能とパイプラインの講義資料も参考になります。クロック・CPI・MIPSの計算全体を確認したい場合は、基本情報のCPU性能計算と単位換算で整理できます。
他のCPU高速化技術との見分け方
パイプラインは、異なる命令の工程を重ねる技術です。似た言葉としてスーパースカラやマルチコアがありますが、何を増やして並行動作させるかが異なります。名称をまとめて「同時に処理するもの」と覚えるより、説明文の対象を見て判断するほうが確実です。
| 用語 | 注目する仕組み | 本記事の式との関係 |
|---|---|---|
| 命令パイプライン | 異なる命令を別々の工程で重ねる | 1本・毎サイクル1命令開始を仮定 |
| スーパースカラ | 複数の命令を同じサイクルに発行できる | 単純な1本の式をそのまま使わない |
| マルチコア | 複数の処理コアを備える | 命令の分配など別の条件が必要 |
| キャッシュメモリ | アクセスの速い記憶で待ち時間を減らす | 工程の重なりとは別の観点 |
たとえば「命令をいくつかの段階に分け、段階をずらして並行実行する」という説明なら、工程の重なりを指しています。「1クロックで複数命令を発行する」という説明なら、1本の単純な命令パイプラインだけの説明ではありません。
実際のCPUでは、こうした技術を組み合わせることがあります。そのため、パイプラインとマルチコアを二者択一にしたり、パイプラインがあればメモリ待ちが起こらないと考えたりしないでください。基本情報の計算問題では、実機の詳細を想像して条件を足すより、指定された構成と無視する要因を確認することが大切です。
複数命令の実行方式をさらに区別する際は、University of Alaska Fairbanksのスーパースカラ講義のモデル比較も確認できます。メモリ待ちの計算は、キャッシュメモリのヒット率と実効アクセス時間へ分けて学ぶと混同を防げます。
基本情報のパイプライン計算とハザード
処理時間の公式を条件から導く
まず、停止がない場合の全体時間を求めます。ステージ数D、命令数N、1段の所要時間Pに対して、最初の命令の完成までDP、残りの命令の完成まで(N−1)Pが必要です。合わせるとT=(D+N−1)Pになります。
「−1」があるのは、最初の命令をDの項ですでに数えたからです。残りがN命令ではなくN−1命令なので、D+Nでは1命令分多く数えることになります。最初の命令が完成した後に、後続命令を1から始め直すのではない点を、時刻表と結び付けてください。
この式を使う条件は、各命令が同じD段を通り、各段が1ピッチで処理され、毎ピッチ1命令を開始でき、途中で停止しないことです。最初はパイプラインが空で、最初の開始から最後の完了までを測るものとします。既に埋まっている区間だけを測る問題では、立ち上がりのD段をもう一度加えません。
問題文に「各ステージは1ピッチ」「ハザードは考慮しない」とあれば、公式の前提と照合しやすくなります。IPAの平成30年1月の修了認定試験・問10も、段数・ピッチ・命令数と無視する条件を指定して処理時間の式を問う形式です。古い問題を学習に使う際も、ここで扱う技術モデルの確認に利用し、現在の試験形式や出題頻度の根拠にはしません。
一次資料:IPAの修了認定試験問題(平成30年1月・問10、PDF)
オリジナル例題として、5段のパイプラインで12命令を実行し、各段は8ns、停止はないとします。必要なサイクル数は5+12−1=16、処理時間は16×8=128nsです。最初の命令が40nsで終わり、その後11命令が8ns間隔で終わる、と別の形で計算しても40+88=128nsになります。
逐次処理との比較では、同じ5工程が各8nsで、命令同士をまったく重ねないと仮定します。このとき1命令は40ns、12命令は480nsです。高速化率は480÷128=3.75倍になります。短縮時間を問われたなら480−128=352ns、短縮割合なら352÷480≒73.3%なので、問いの単位まで確認しましょう。
この比較は「同じ工程時間で、段間の追加遅延などは無視する」という前提です。実機での効果を表す測定値ではありません。命令数が増えると、この理想モデルの高速化率は段数に近づきますが、12命令の例で段数の5をそのまま答えにするのは誤りです。立ち上がりの時間も含む有限個の命令については、必ず全体時間を割って求めます。
サイクルと単位をそろえる
計算は「サイクル数を求める」「1サイクルの時間を掛ける」の順に分けます。先に数字だけをまとめると、命令数と時間の単位が混ざりやすくなります。Pがnsなら答えもns、Pが秒なら答えも秒になることを、式の最後で確認してください。
クロック周波数fが与えられているときは、1サイクルの時間P=1/fに変換します。たとえば200MHzなら、1秒あたり2億サイクルなのでP=5nsです。4段で9命令なら、4+9−1=12サイクル、12×5=60nsとなります。周波数の200をそのまま12に掛ける計算にはしません。
| 問題で分かる値 | 先に求めるもの | 例 |
|---|---|---|
| 各段10ns | そのまま1ピッチの時間として使う | 7サイクル×10ns=70ns |
| 1周期5ns | 段が1周期ならP=5ns | 12サイクル×5ns=60ns |
| 周波数200MHz | P=1÷周波数 | P=5ns |
| 各段の作業時間が異なる | 共通周期の決め方を確認 | 単純な同期モデルなら最も遅い段が基準 |
各ステージの作業時間が異なる場合にも注意が必要です。すべての段が共通クロックで進み、段間遅延を無視できるモデルなら、1周期は最も時間のかかる段が処理を終えられる長さにします。各段の時間の平均を周期として使うと、遅い段が間に合わなくなります。
たとえば3段の作業時間を6ns・10ns・8nsとする同期モデルでは、共通周期は少なくとも10nsです。各命令は3周期を通るので、4命令の全体時間は(3+4−1)×10=60ns。比較対象の逐次処理が工程間の待ちを入れず6+10+8=24nsで1命令を処理できるなら、4命令は96ns、高速化率は96÷60=1.6倍です。
この例で逐次側まで3×10=30nsとすると、比較対象の条件を変えてしまいます。「非パイプラインでも同じ10ns周期を使う」など別の条件が指定されれば、その条件に従ってください。式の数字をそろえる前に、どちらが何を1周期として動作するかを見る必要があります。
さらに、パイプラインレジスタの遅延が1ns加わると明示されていれば、この単純な例の周期は10+1=11nsとなり、全体は6×11=66nsです。指定のない追加遅延を勝手に加えず、指定がある遅延を省かないことがポイントです。実際の回路設計の詳細へ広げるより、問題で無視できるとされた要因を確認しましょう。
ストールと3種類のハザード
ハザードは、命令を予定どおり次の工程へ進められない要因です。主な分類は構造ハザード、データハザード、制御ハザードの3つ。何が足りない、または何がまだ決まっていないのかで見分けます。ハザードを解消するために進行を待たせることがストールです。
| 種類 | 原因 | 考え方の例 |
|---|---|---|
| 構造ハザード | 同時に必要なハードウェア資源が足りない | 命令取得とデータ読出しが同じメモリ装置を取り合う |
| データハザード | 前の命令の結果を後の命令が必要とする | 計算結果が利用可能になる前に次の演算が使おうとする |
| 制御ハザード | 分岐などで次に実行する命令が確定しない | 分岐先が決まるまで命令取得を待つ |
構造ハザードでは、値の正しさよりも装置の取り合いが問題です。1つのメモリ資源しか同時に使えないと仮定すると、ある命令のデータ読出しと別の命令の取得が衝突する場合があります。資源を分けたり、アクセスのタイミングをずらしたりする方法が考えられますが、必ず解決できると条件なしに断定はしません。
データハザードの例は、「AでR1に計算結果を入れる」「BでR1を使って次の計算をする」という依存です。Bが古いR1を使ってしまうと計算結果が誤るため、必要な値が使えるタイミングまで待つなどの対処が必要です。命令の間に依存があることと、実際に停止が何サイクル必要かは別の情報になります。
計算結果をレジスタへの書き戻し前に後の工程へ直接渡すフォワーディングは、データハザードによる待ちを減らす方法です。ただし、どの工程で結果が得られ、どの工程で必要になるかによっては待ちが残ります。「フォワーディングあり」だけでストールを必ず0と決めず、問題で指定された利用タイミングを見てください。
ハザードの分類は東京工業大学のパイプライン処理とハザードの講義資料(PDF)、フォワーディングと停止の関係はUniversity of San Franciscoのハザード講義で確認できます。
停止の計算では、原因名だけでなく「全体の完了が何サイクル延びるか」を確認します。4段・4命令で理想は7サイクルでも、全体を合計2サイクル遅らせる待ちがあるなら9サイクルです。1段10nsなら90nsになります。ここで足す2は、命令数でも段数でもなく、理想より増えるサイクル数です。
次の時刻表は、Bの解読Dを2サイクル延長し、Cも次の工程へ進めず、新しいD命令の取得を遅らせる簡略モデルです。待機中にAは先へ進みます。実際のCPUの特定の回路動作を再現する図ではなく、「後続の列がどれだけ右へ伸びるか」を読むための例です。
| 命令/サイクル | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| A | F | D | E | W | — | — | — | — | — |
| B | — | F | D | 待 | 待 | E | W | — | — |
| C | — | — | F | 待 | 待 | D | E | W | — |
| D | — | — | — | — | — | F | D | E | W |
表に「待」が4セルあるから4サイクル追加、とは計算しません。BとCは同じサイクル4・5で待っており、経過時間の増加は2サイクルです。命令ごとの待ち時間を合計すると、同時に発生した待ちを二重に数えるおそれがあります。図では最後の完了列を見て確認してください。
問題が合計追加サイクルSを明示し、待ちの重複も処理済みならT=(D+N−1+S)Pを使えます。各ハザードの発生回数だけが与えられた場合は、1回あたりのペナルティや重複の条件も必要です。情報がないのに「データハザードは必ず2サイクル」と補ってはいけません。
分岐による停止と計算の確認
制御ハザードは、分岐命令などによって次の命令の流れが定まらないときに起こります。たとえば条件により進む先が変わるなら、後続命令をどちらから取得するかが問題になります。後続を待たせる方法のほか、分岐予測に基づいて先へ進め、予測が外れたら不要な処理を取り消す方法があります。
取り消しはフラッシュと呼ばれ、待機のストールと同じ言葉ではありません。待機は進行を保留し、取り消しは誤った経路の命令を有効な処理から外します。フラッシュで空きができると結果的に全体時間が延びるので、計算では指定された失敗時の追加サイクルを用います。
ただし、1回の分岐で失うサイクル数は、分岐を確定する工程や予測方法などに依存します。段数から自動的に損失を決められるとは限りません。モデルの指定なしに、すべての5段パイプラインの分岐損失を同じ値として扱わないでください。
確認問題を3つ解いてみましょう。まず問Aは、6段、15命令、1段4ns、停止なしの場合の全体時間です。問Bは、4段、6命令、1周期12nsで、全体を延ばす追加の待ちが合計3サイクルと指定された場合の時間。問Cは、「命令Aが計算するR2を、後の命令Bが完成前に読もうとする」場合のハザード分類です。
問Aでは6+15−1=20サイクル、20×4=80nsです。最初の24nsに残り14命令×4nsを足しても80nsとなり、−1の扱いを二通りで確認できます。問Bは4+6−1+3=12サイクル、12×12=144nsです。理想の9サイクルに3を加えるので、命令数6に待ちを掛ける必要はありません。
問Cはデータハザードです。必要なのはAが生成する新しい値なので、装置の取り合いを原因とする構造ハザードとは異なります。この記述だけでは何サイクル待つかは分かりません。分類問題では原因を答え、時間計算ではタイミングの追加条件を探す、という分け方をしてください。
| 誤った計算・解釈 | 見直す箇所 | 正しい確認方法 |
|---|---|---|
| 段数×命令数を全体時間にする | 工程の重なりを無視していないか | 最後の命令の最終工程まで列を数える |
| 段数+命令数で数える | 最初の命令を二重に数えていないか | 最初の1命令+残りN−1命令で分ける |
| 周期にクロック周波数を掛ける | 周波数と時間を混ぜていないか | P=1/fとしてから掛ける |
| 待機セルの数だけ足す | 同じ時間区間の待ちを重複計上していないか | 終了列が何列延びたかを確認する |
| 段数倍が常に高速化率になる | 立ち上がりの影響を除いていないか | 比較対象の全体時間÷パイプライン時間で求める |
解答に迷ったときは、命令数を1に置き換えて公式を点検する方法も使えます。T=(D+1−1)P=DPとなれば、1命令が全段を通る時間と一致します。誤って(D+N)Pと書いた式では、1命令でも余分な1周期が加わるので、ずれに気付きやすくなります。
次に、2命令目が完成する時刻を小さな図で確かめます。停止なしなら1命令目から1周期後、停止ありなら指定された分だけ遅れます。大きな命令数の表をすべて書く必要はなく、最初の2〜3命令と最後の命令の位置を押さえれば、公式と図が一致するか確認できます。
基本情報のパイプラインを解く手順
基本情報のパイプライン問題では、最初に「1命令の所要時間」「全命令の終了時刻」「単位時間の完了数」のどれを求めるかを決めます。次に、段数・命令数・1ピッチの時間を抜き出し、1本のパイプラインか、停止や段間遅延を無視するかを確認してください。
停止なしの全体時間なら、最初の命令にD周期、残りN−1命令に1周期ずつを割り当てます。停止がある場合は、問題が指定した追加サイクルを加えるか、時刻表で最後の完了列を読みます。最後に周期の単位を掛け、問われた時間・高速化率・短縮割合の形に変換します。
復習では答えの数字だけでなく、「なぜ−1をするか」「同じサイクルで何が動くか」「待ちが全体を何列延ばすか」を説明できるか確認すると理解を点検できます。公式に数字を入れられても図を読むと混乱するなら、4段・3命令程度の表を自分で書き直すところから戻りましょう。
考え方を確認できたら、基本情報の過去問アプリで無料演習できます。今すぐ問題を解きたい方に向く導線です。分野をコンピュータ構成要素・プロセッサなどに絞り、解答後に段数と周期、停止条件を見直してみてください。図の読み方がまだ不安なら、先に本文の時刻表と例題で確認してから進めると取り組みやすくなります。

コメント