基本情報のデータ圧縮は、「元へ完全に戻せるか」と「何を利用して短くするか」を分けると理解しやすくなります。可逆圧縮は圧縮前のデータを完全に復元でき、非可逆圧縮は一部の情報を失うため完全には戻せません。
ハフマン符号は、出現頻度が高い記号へ短い符号を割り当てる可逆圧縮です。問題では頻度の小さい二つを結合して木を作り、根から記号までの枝を読んで符号を求めます。平均符号長は、各記号の出現確率と符号長を掛け、その合計で計算できます。
この記事では、可逆・非可逆の選び分けから、ランレングスの計算、ハフマン木の作成、平均符号長、復号の演習までを順に説明します。式の答えだけでなく、途中で何を確認すれば取り違えを防げるかも一緒に確かめていきましょう。
- 完全復元が必要なデータと、情報損失を許容する用途を区別できる
- 連続する回数と全体の出現頻度を別々に数えられる
- ハフマン木から符号を読み、平均符号長を計算できる
- 学習用の例題で圧縮率と復号の検算を練習できる
基本情報のデータ圧縮の仕組み
可逆・非可逆は完全復元で分ける
データ圧縮とは、保存や伝送に必要なデータ量を減らすために表現を工夫することです。圧縮したデータを元の表現へ戻す処理は伸長と呼ばれます。符号へ変換する場面では符号化、符号から記号を読み戻す場面では復号という言葉も使います。圧縮後のファイルが小さいという結果と、復元した内容が正確かという性質は、別々に見る必要があります。
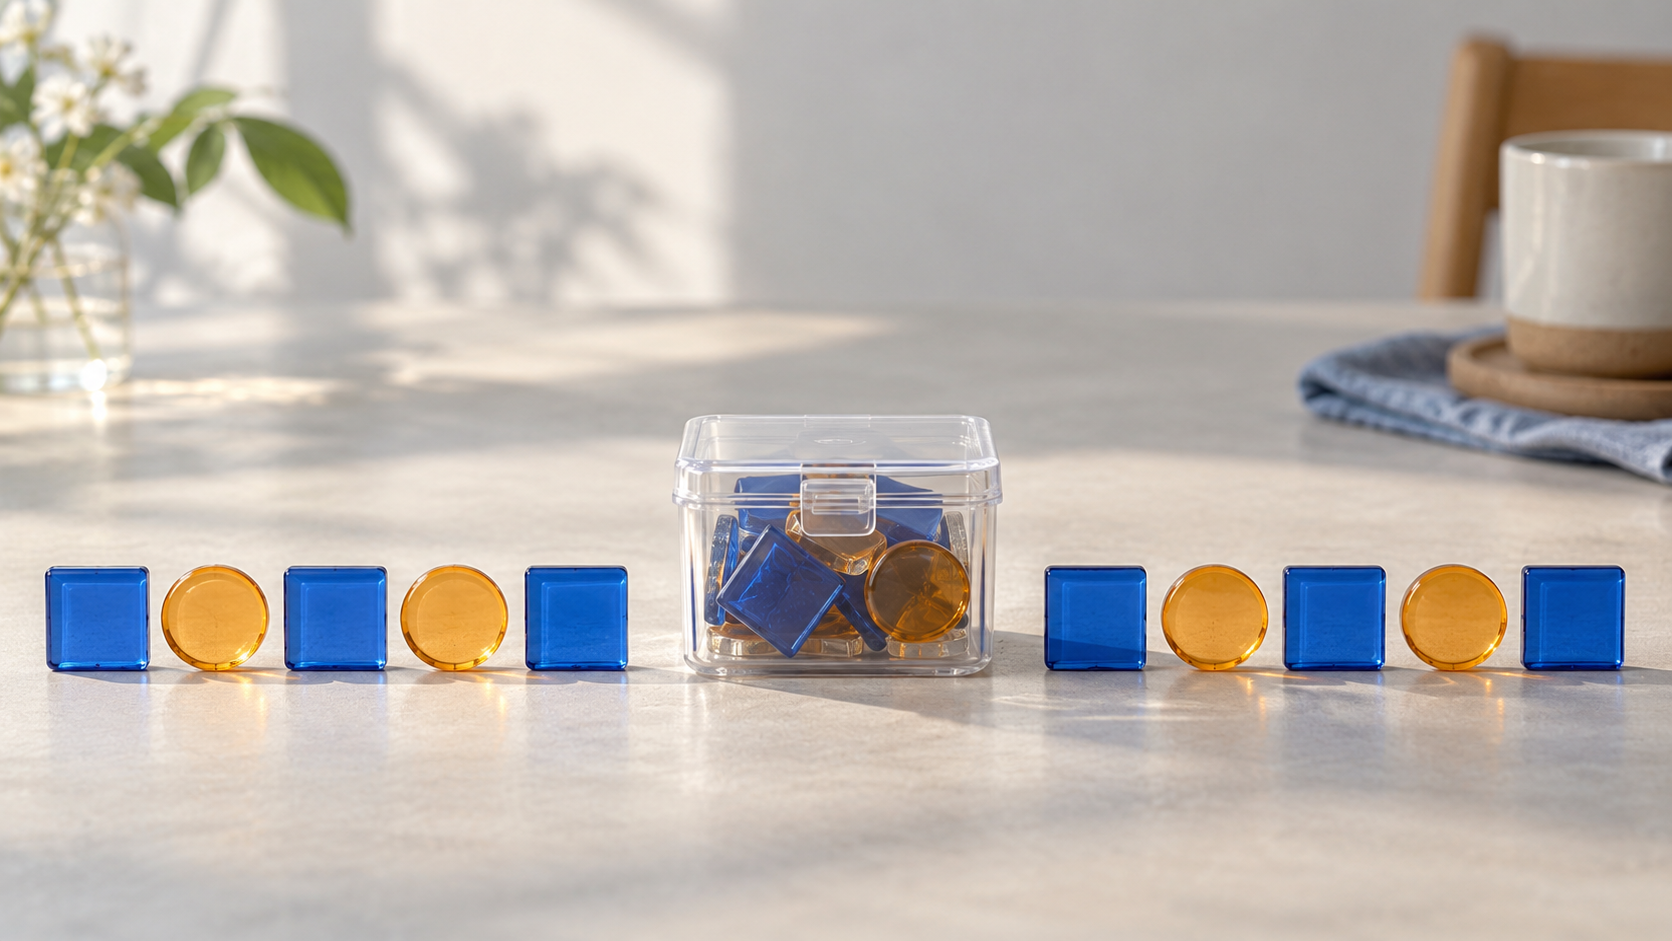
可逆圧縮では、伸長後のデータが圧縮前と一致します。例えば、連続する青い印を「青が六個」と記録しても、種類と個数が分かれば六個の青い印へ戻せます。記録の仕方を変えただけで、復元に必要な情報は残っています。ロスレス圧縮という呼び方も、この情報を失わない性質を表しています。
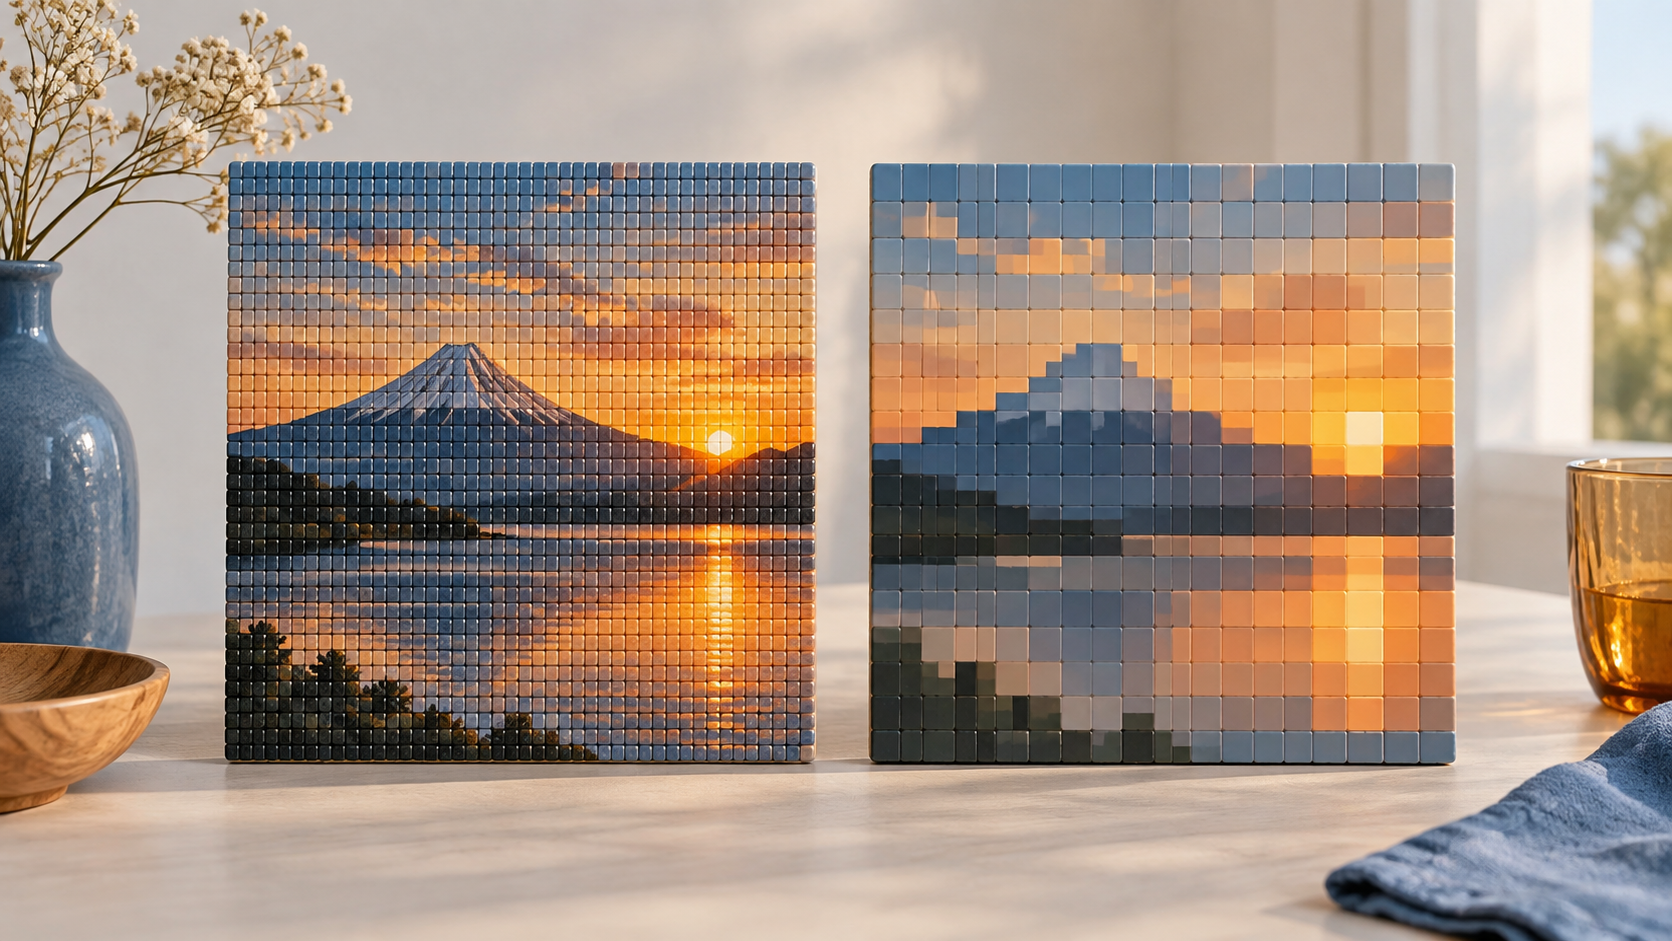
非可逆圧縮では、データ量を減らす過程で情報の一部を失います。細かな色の違いを近い色へまとめた場合、復元側には元がどの色だったかを区別する情報が残りません。大まかな見た目が似ていても、元データとの完全な一致は保証できないわけです。ロッシー圧縮という呼び方も合わせて覚えておくと説明を読みやすくなります。
| 比較する点 | 可逆圧縮 | 非可逆圧縮 |
|---|---|---|
| 元データの完全な復元 | できる | 一般にできない |
| 利用の判断 | 内容の正確な保存が必要 | 用途に応じて情報損失を許容する |
| 代表的な考え方 | 繰り返し・頻度を利用して表現を変える | 不要と判断する情報を減らす |
| 基本情報での読み分け | 元へ完全に戻せるという条件 | 画質・音質と容量の調整という条件 |
プログラム、設定ファイル、計算に使う数値などは、勝手に内容が変わると困ります。こうしたデータには完全復元できる方法が必要です。一方、閲覧用の写真や配信用の音声では、用途に合う品質を保ちながら容量を抑える選択ができます。ただし写真だから必ず非可逆、音声だから必ず非可逆という決め方はしません。実際の方式と求める復元精度が判断の基準です。
可逆・非可逆の区別と、ランレングス・ハフマン符号による演習は、情報検定の公式公開問題「令和4年度後期・情報システム試験 基本スキル」でも確認できます。この資料は基本情報の過去問ではないため、試験の出題頻度の根拠とは分けて利用してください。
ファイル形式と圧縮方式を区別する
身近な例ではZIPのような可逆圧縮と、一般的なJPEG保存のような非可逆圧縮を対比するとイメージしやすいですね。ただし、ファイル形式名と圧縮アルゴリズム名は同じ種類の用語ではありません。ZIPはファイルをまとめる形式でもあり、内容を圧縮する方式は別に定まります。問題文に方式の条件がある場合は、拡張子だけで結論を出さないようにしましょう。
PNGは、画像を可逆に圧縮する形式です。仕様では画像データの圧縮にDeflateを使うことが定められています。詳しい条件はW3CのPNG仕様で確認できます。一方、同じ画像を扱う形式でも、写真の細かな情報を削って容量を減らす保存と、画素値を保って圧縮する保存では性質が変わります。
ここでいう完全復元は、「圧縮の入力になったデータ」を復元できるという意味です。すでに画素数を減らした写真をPNGへ保存しても、削除済みの画素は戻りません。可逆圧縮は、以前の編集や変換で失った情報まで復活させるものではないからです。圧縮の前後でどのデータを比較しているのかを意識すると、説明の範囲を取り違えずに済みます。
例えば、元の写真を非可逆方式で保存してから、そのファイルをZIPへ入れた場合を考えます。ZIPを伸長すれば、ZIPへ入れる直前のファイルは正確に取り出せます。しかし、その中の画像が最初の写真と完全に一致するとは限りません。「最後の処理が可逆なら、全工程の情報損失もなくなる」という選択肢は、この二つの比較を混ぜています。
アナログ音声の標本化・量子化・符号化も、圧縮方式の分類と混同しやすいテーマです。標本化などはアナログ信号をデジタル表現へ変える段階で、圧縮は出来上がったデータをどう小さく表すかという段階です。PCMの録音容量の式を覚えていても、その式だけで圧縮後の容量が決まるわけではありません。この記事ではデータがすでに記号列やビット列として与えられている場合を中心に扱います。
ランレングスは連続する回数を数える
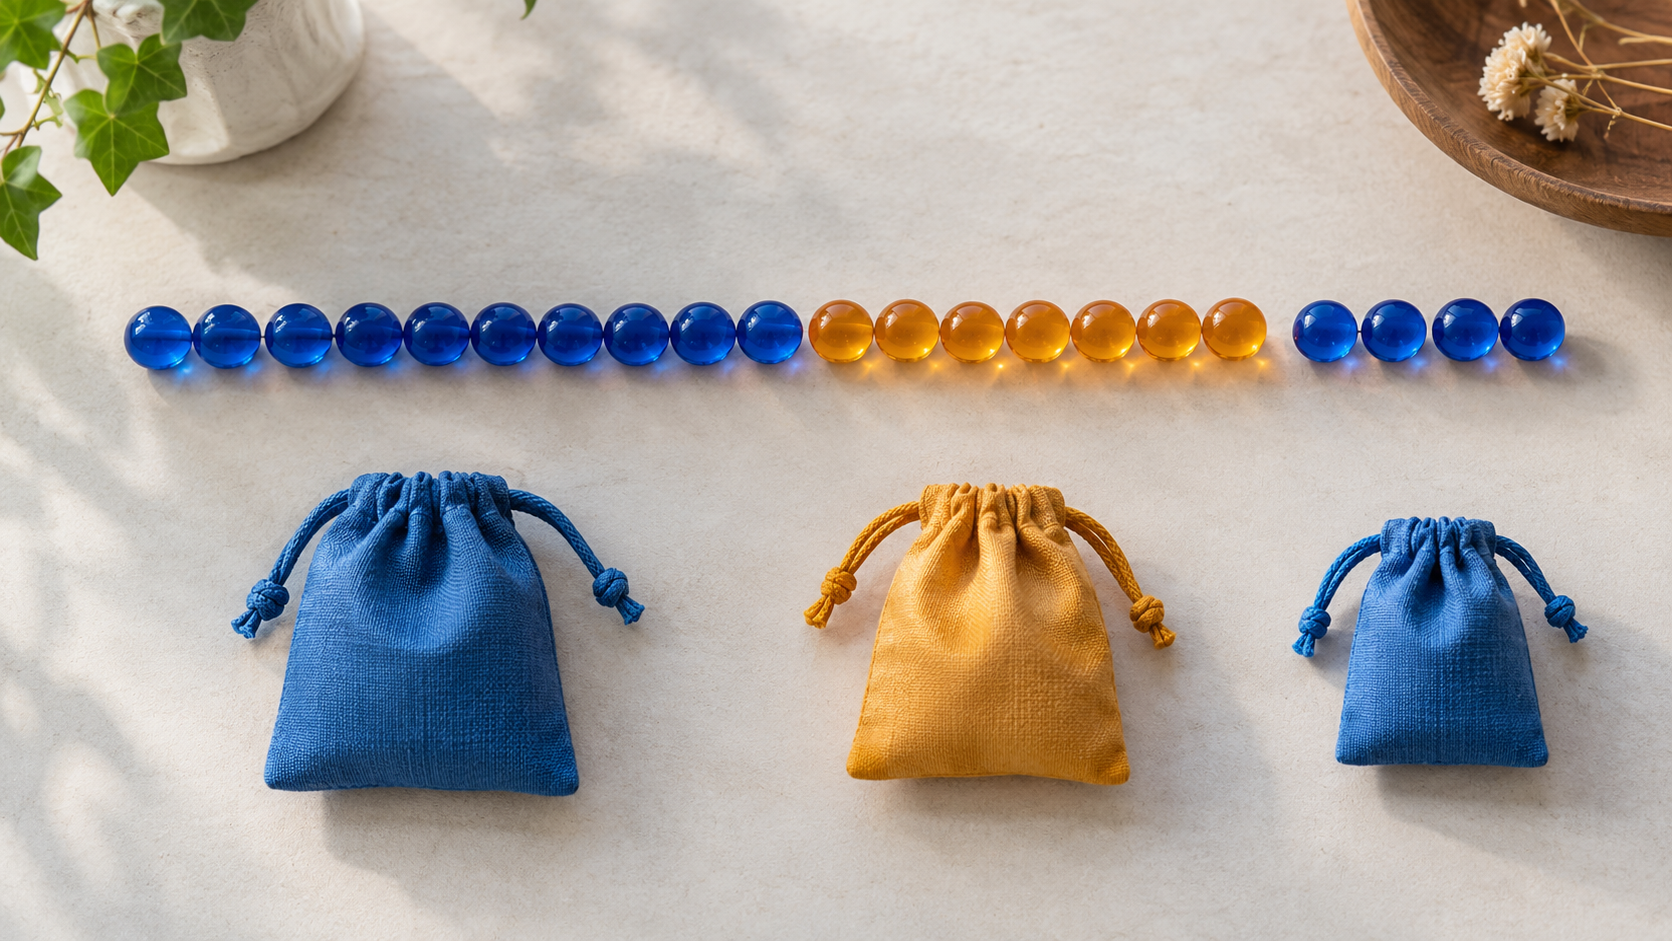
ランレングス符号化は、同じ値が連続する部分を値と連続回数で表す可逆圧縮です。連長圧縮とも呼びます。ここで大切なのは「同じ文字が合計で何回出たか」ではなく、「同じ文字が途切れずに何回続いたか」です。途中に別の文字が挟まったら、前のまとまりを閉じ、新しいまとまりを数え始めます。
学習用に、文字列AAAAAABBBAAを考えます。左から読むとAが六回、Bが三回、Aが二回続いているので、値と回数の組では(A,6)(B,3)(A,2)です。便宜上A6B3A2と書いてもよいですが、これは説明用の表記です。実際の記録量を計算するには、文字や回数を何ビットで保存するかという条件が必要になります。
この例で、元の文字一個を8ビット、圧縮後は値8ビットと回数8ビットの組で記録し、付加情報は無視するとします。元は11文字なので88ビットです。圧縮後は三組×16ビット=48ビットになります。括弧や区切りのカンマは計算に入れません。問題が指定した記録形式を数えているのであり、説明用の見た目の文字数を数えているわけではないからです。
圧縮後÷圧縮前で比を求めるなら48÷88=約0.545、つまり約54.5%です。減った割合なら(88−48)÷88=約45.5%になります。「元の何%になるか」と「何%削減したか」は答えが異なります。圧縮率という名前だけを見ず、問題文に示された分子と分母を先に書く習慣をつけましょう。
連続がないABABABを同じ方式で記録すると、(A,1)(B,1)(A,1)(B,1)(A,1)(B,1)の六組です。元の48ビットに対して圧縮後は96ビットで、二倍へ増えます。ランレングスは長く連続するデータでは有効でも、細かく値が切り替わるデータには不利になることがあります。圧縮という名前でも必ず小さくなるとは限りません。
白黒だけの画像などでは、最初の色が分かり、色が必ず交互に切り替わるという条件なら、各区間の長さだけを記録する方法も考えられます。この場合は毎回の色を記録する方式とは計算が変わります。また、回数を8ビットの符号なし整数で記録するなら、長い連続を一組で記録できる上限もあります。方式名が同じでも、試験では問題文の記録規則を優先してください。
ハフマン符号は頻度と符号長を見る
ハフマン符号は、記号の出現頻度の偏りを利用する可逆圧縮です。よく使う記号を短く、あまり使わない記号を長く表すことで、全体の符号量を抑えます。文字ごとの符号が同じ長さなら固定長符号、異なる長さを使うなら可変長符号です。ただし、可変長なら何でも正しく読めるわけではありません。
例えばAを0、Bを01、Cを1と決めると、ビット列01はB一文字とも、AとCの二文字とも読めます。短い符号を割り当てたつもりでも、区切りを判断できなければ復元できません。このような曖昧さを避けるため、ハフマン符号では、どの記号の符号も別の記号の符号の先頭部分にならない形にします。これを接頭語がない符号、接頭語自由な符号といいます。
Aが0、Bが10、Cが110、Dが111という符号表なら、0を読んだ時点でAと分かります。1を読んだ場合は続きが必要で、10まで読めばB、11ならさらに一ビット読んでCかDを判断できます。符号表を送受信側で共有していれば、文字の間に区切り記号を入れなくても、左から順に読み戻せるわけです。
ランレングスと違い、ハフマン符号では同じ記号が連続している必要はありません。例えばAが多い二つの文字列があり、文字の順番が違っても各記号の出現回数が同じなら、同じ符号表を使った符号本体の長さは同じです。並び順は符号列として保存されます。頻度を利用するからといって、元の文字列を頻度順へ並べ替えて保存するのではありません。
| 問題文の着眼点 | まず考える方式 | 確認する条件 |
|---|---|---|
| 同じ値が連続する | ランレングス | 区間数と回数の保存形式 |
| 多く出る記号を短い符号へ置換 | ハフマン符号 | 頻度・木の結合規則・符号表 |
| 既出の文字列を参照して表す | 辞書式の圧縮 | 参照位置と長さの記録規則 |
| 一部の情報を省いて容量を減らす | 非可逆圧縮 | 失う情報と許容される品質 |
ハフマン符号が可逆であること、接頭語を持たない符号の性質、木を作る基本手順は、東邦大学の教材「ハフマン符号」で確認できます。ここから先の数値例は、手計算しやすい条件で作った学習用のオリジナル例です。
圧縮できる範囲と付加情報に注意する
「ハフマン符号を使えば、あらゆるデータが大きく圧縮できる」と覚えるのは避けましょう。効果は出現頻度の偏りや、比較する元の符号長に左右されます。四種類の記号が同じ確率で出るなら、各記号を二ビットで表す固定長符号でも効率よく記録できます。頻度に偏りが少ない場合は、可変長にしただけで大きく短縮するとは限りません。
また、ハフマン符号で「最適」と説明されるときは、一定の記号の出現確率に対して、各記号へ二進の接頭語自由な符号を割り当てるという条件に注目してください。辞書式の処理や複数記号をまとめる方法など、あらゆる圧縮の工夫を含めて最小のファイルになるという意味ではありません。基本情報の演習では、問題が与えた記号と頻度の範囲で計算すれば十分です。
符号本体以外の情報も考える必要があります。圧縮側だけが符号表を知っていても、受け取った側は元の文字列へ戻せません。あらかじめ共通の表を持つか、ファイルへ表や木の情報を添えるなどの方法が必要です。本体が短くなっても、表の保存量が大きければファイル全体の削減量は小さくなります。短いデータでは、付加情報の影響が特に目立ちます。
例えば、元のデータ本体が200ビットで、圧縮した本体が175ビット、符号表などが40ビットなら、全体は215ビットです。本体だけなら25ビット削減できていますが、付加情報込みでは15ビット増えています。問題文に「符号表の記録量を無視する」とある場合と、表の大きさが与えられている場合で、同じ175という値の使い方が変わることを確認しましょう。
圧縮と暗号化も目的が違います。圧縮は表現を短くすること、暗号化は内容を知られにくくすることが目的です。圧縮ファイルだから秘密が守られているという意味にはなりません。また、圧縮と誤り検出も別です。ビット列が短く読めることと、通信中の破損を検出・訂正できることを同じ性質として扱わないようにしましょう。
基本情報のデータ圧縮問題の解き方
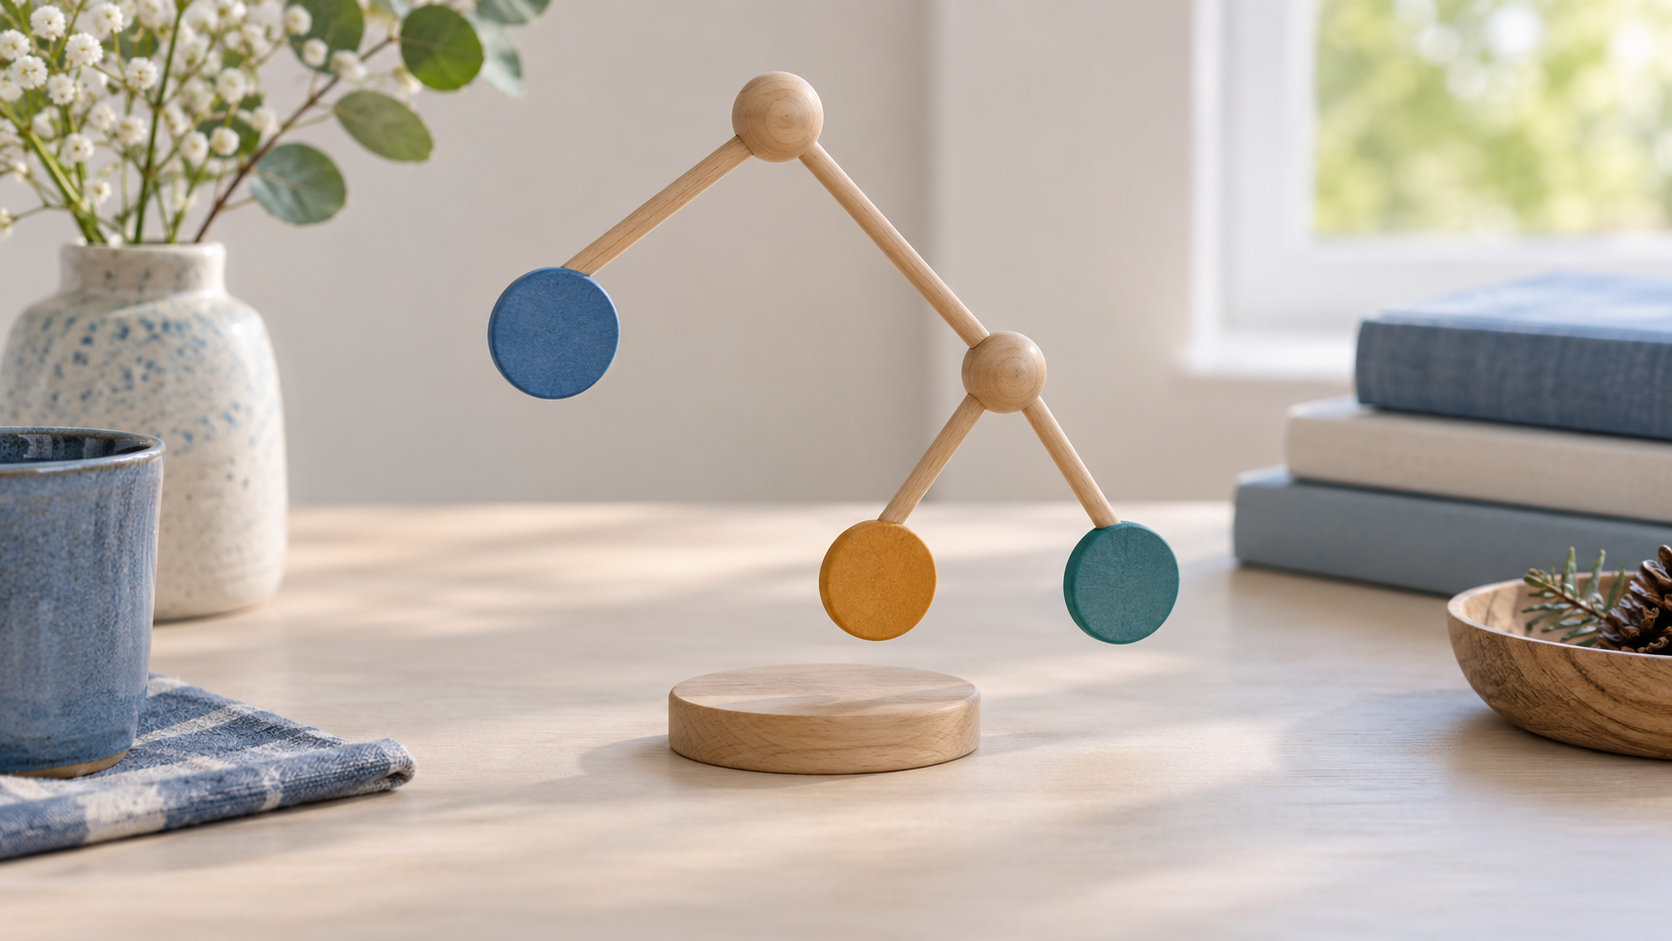
頻度の小さい二つでハフマン木を作る
ここではA・B・C・Dの四種類があり、出現回数はAが50回、Bが25回、Cが15回、Dが10回、合計100回とします。文字の順番は符号表の作成には使いません。最初に回数を表へ書き、合計が100であることを確かめます。確率へ直せば0.50、0.25、0.15、0.10ですが、木の作成は回数のままでも進められます。
最初に一番小さいDの10とCの15を結合し、重み25のまとまりCDを作ります。次の候補はAの50、Bの25、CDの25です。結合したCとDは、以後別々の候補としては数えません。一度まとめたものを一つの候補として戻し、残っている候補全体から小さい二つを選び直す点が重要です。
二回目はBの25とCDの25を結合して、重み50のまとまりBCDを作ります。候補はAの50とBCDの50の二つになるので、最後に結合して重み100の根を作ります。四種類の記号なら結合は三回です。一回結合するたびに候補数が一つ減るため、一般に記号がn種類ならn−1回で一つの木になります。
| 段階 | 結合する二つ | 結合後に比較する候補 |
|---|---|---|
| 開始 | まだ結合しない | D:10、C:15、B:25、A:50 |
| 最初の結合 | D:10とC:15 | B:25、CD:25、A:50 |
| 次の結合 | B:25とCD:25 | A:50、BCD:50 |
| 最後の結合 | A:50とBCD:50 | 根:100 |
符号を割り当てる際は、ここでは根から見てAへ向かう枝を0、BCDへ向かう枝を1とします。BCDからBへは0、CDへは1、CDからCへは0、Dへは1とします。するとA=0、B=10、C=110、D=111です。結合は小さい側から積み上げましたが、符号を読む向きは根から記号へ向かう方向になります。
もし根の0と1を逆にすれば、Aの符号そのものは変わります。しかしAまでの枝は一本なので、符号長は一ビットのままです。同じ頻度の候補がある場合も、選び方や左右の置き方によって符号が異なることがあります。問題文が「小さい方を左」「左枝を0」などと指定しているなら、その規則に従ってください。指定がないのに、例と符号が違うだけで間違いだとは決めません。
木の深さが分かりにくい方は、基本情報の木構造・二分木と走査順の解説で根・枝・葉の位置関係を確認すると読みやすくなります。ただし、この問題で数えるのは根から葉までの枝の本数です。根を含む節の個数を数えると、符号長を一ビット多く見積もってしまいます。
平均符号長は確率で重み付けする
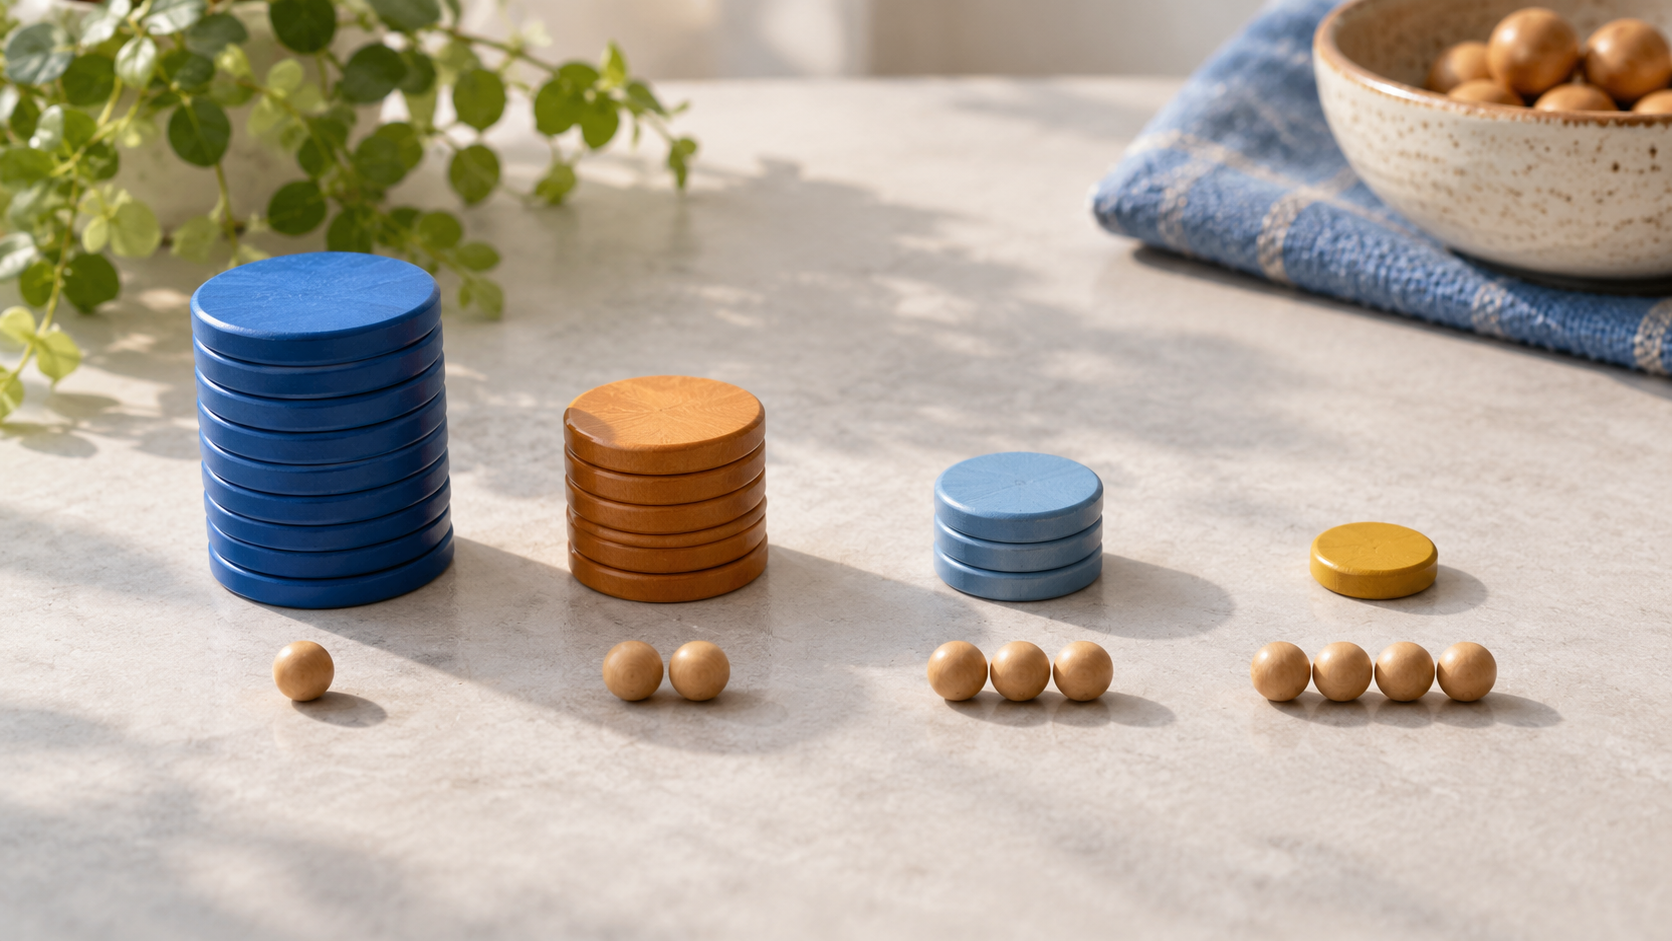
平均符号長は、記号を一個送るときに平均して何ビット必要かを表します。各記号の出現確率をp、符号長をlとすると、平均符号長Lは「各記号のp×lの合計」です。平均なので、小数になっても問題ありません。一個の記号の符号が1.75ビットになるわけではなく、長さの違う記号を多数まとめて見た平均が1.75ビットになります。
| 記号 | 回数 | 確率 | 符号例 | 符号長 | 確率×符号長 |
|---|---|---|---|---|---|
| A | 50 | 0.50 | 0 | 1 | 0.50 |
| B | 25 | 0.25 | 10 | 2 | 0.50 |
| C | 15 | 0.15 | 110 | 3 | 0.45 |
| D | 10 | 0.10 | 111 | 3 | 0.30 |
| 合計 | 100 | 1.00 | — | — | 1.75ビット/記号 |
計算は0.50×1+0.25×2+0.15×3+0.10×3=1.75ビット/記号です。確率が50%と書かれていれば0.50へ直します。(1+2+3+3)÷4=2.25という単純平均ではありません。四種類の記号が同じ回数出る場合と違い、今回は一ビットのAが全体の半分を占めるため、その頻度を反映する必要があります。
回数で計算する場合は、先に符号の総量を求めても構いません。50×1+25×2+15×3+10×3=175ビットです。100記号で割れば175÷100=1.75ビット/記号となり、確率を使った式と一致します。確率と回数のどちらで解いてもよいですが、回数を掛けた合計をそのまま平均符号長と答えないように注意してください。
比較対象を、四種類の記号それぞれに二ビットを割り当てる固定長符号とします。その総量は100×2=200ビットです。符号表などを無視した圧縮後の割合は175÷200=87.5%、削減率は12.5%です。「一文字を8ビットで保存した場合」と比べるなら元は800ビットになり、別の割合になります。同じ圧縮後データでも、比較対象の条件が変われば圧縮率は変わります。
検算には、木を作るときにできた結合後の重みを足す方法も使えます。今回なら25+50+100=175です。各記号の回数は、その記号から根までの各結合で一度ずつ足されるため、合計は「回数×枝の本数」の総和と一致します。平均を得るなら175を総回数100で割ります。計算に不安があるとき、符号表で求めた175と木の重みで求めた175を照合できます。
固定長の必要ビット数も確認しましょう。kビットなら2のk乗通りを表せるので、四種類なら二ビット、五種類なら三ビットが必要です。五種類だから五ビットとは限りません。指数や二進数の表し方を復習したい場合は、基本情報のn進数と2進数・16進数の変換へ進むと、比較元の容量を自分で判断しやすくなります。
符号化・復号は表を固定して追う
符号表がA=0、B=10、C=110、D=111と指定されているなら、木を作り直す必要はありません。指定された符号表をそのまま使います。符号化では元の記号の順番を保って、それぞれを符号へ置換し、つなぎます。例えばABACADなら、0・10・0・110・0・111を連結して01001100111となります。読みやすく付けた点や空白は、送るデータの一部ではありません。
符号量は文字列の構成からも確認できます。ABACADにはAが三回、B・C・Dが一回ずつあるため、3×1+1×2+1×3+1×3=11ビットです。実際に連結した01001100111も11桁なので一致します。この六文字は、先ほどの頻度50%・25%・15%・10%の100文字データとは異なります。平均符号長1.75を六倍して、この特定の文字列の正確な長さを求めることはできません。
復号は左から読み、符号表の一つに一致したところで記号を確定します。ビット列0101111100なら、最初の0でA、次の10でB、続く111でD、次の110でC、最後の0でAです。結果はABDCAとなります。どこでも好きに区切ってから表を探すのではなく、先頭から記号が確定するまで読んで、確定したら次の記号へ進みます。
木を使う場合も同じです。0か1を一ビット読むたびに対応する枝を進み、葉に着いたらその記号を出力して根へ戻ります。次のビットは根から読み始めます。前の葉の位置を保ったまま次の文字を探すと、木の外へ進もうとしてしまいます。「葉で確定したら根へ戻る」という動作を、手で追うときにも繰り返してください。
読んだ最後が途中の節で終わり、符号表のどの記号にも一致しない場合は、完全な記号列としては復号できません。例えばこの表で末尾に11だけ残ると、Cの110なのかDの111なのかを確定できません。問題が完全な符号列を与えているなら、途中での区切り、写し間違い、符号表の見落としを先に点検する場面です。
「出現頻度が同じなら、復号した文字列も同じになる」という考え方にも注意しましょう。頻度は符号表を設計する材料ですが、文字列の並び順は符号列の順番に残っています。ABBとBABは同じ回数でAとBが現れても、符号列は01010と10010で異なります。平均符号長を求める問題と、元の並びを求める問題では、見る情報が違います。
練習問題で計算と条件を確かめる
以下はすべて学習用のオリジナル問題です。符号表・ヘッダー・区切りなどの付加情報は、指定がある問題以外では無視します。解答を見る前に、何を求める問題かを「方式の判定」「木の作成」「符号の総量」「平均」「復号」に分け、使う条件をメモしてから解いてみてください。
| 問題 | 条件と問い |
|---|---|
| 可逆・非可逆の判定 | 画素の細かな違いをまとめ、元の画素値を完全には戻せない方式はどちらか |
| ランレングスの容量 | AAAABBAAAAを値8ビット・回数8ビットの組で記録する。元も一文字8ビットとすると前後の容量は何ビットか |
| 平均符号長 | A:40回、B:30回、C:20回、D:10回からハフマン木を作る。平均符号長は何ビット/記号か |
| 五種類の符号量 | A:40回、B:25回、C:15回、D:12回、E:8回をハフマン符号にする。符号本体の総量はいくつか |
| 指定表による復号 | A=0、B=10、C=110、D=111で、110010111を復号する |
| 付加情報込みの比較 | 圧縮前400ビット、圧縮後の本体300ビット、表など40ビット。全体は元の何%か |
可逆・非可逆の判定の答えは非可逆です。画素の違いをまとめたことで、異なる入力が同じ結果になる可能性があります。元の画素値を区別する情報が残らないため、完全復元できません。結果がきれいに見えるか、ファイルサイズがどれだけ小さいかは、この判定の直接の基準ではありません。
ランレングスは(A,4)(B,2)(A,4)の三組です。元は10文字×8=80ビット、圧縮後は三組×16=48ビットです。Aが合計八回あるから(A,8)(B,2)にまとめると、Bの位置が変わって元の文字列へ戻せなくなります。全体の回数が同じでも、連続する区間を保つ必要があることを、この問題で確認できます。
平均符号長の問題では、Dの10とCの20を結合して30、Bの30とそのまとまりの30を結合して60、Aの40と60を結合して100とします。一例ではAの長さが一ビット、Bが二ビット、CとDが三ビットです。0.40×1+0.30×2+0.20×3+0.10×3=1.90ビット/記号です。結合後の重み30+60+100=190を100で割っても同じ答えになります。
五種類の問題では、8と12を結合して20、15と20を結合して35、25と35を結合して60、40と60を結合して100となります。符号長はAが一、Bが二、Cが三、DとEが四です。総量は40×1+25×2+15×3+12×4+8×4=215ビットです。重みの合計20+35+60+100=215でも検算できます。固定長なら五種類を表すため一記号三ビット必要なので、100記号で300ビットです。
復号の問題は110・0・10・111と読めるので、答えはCABDです。符号長は3+1+2+3=9ビットで、問題の符号列の桁数と一致します。先ほどの100記号データとは条件が違うため、平均符号長の式を使って記号数を決めるのではなく、与えられた表で実際に読む必要があります。
付加情報込みの問題は、本体300+表など40=340ビットです。元の何%かなので340÷400×100=85%になります。削減率を聞かれた場合は15%です。表を無視して75%と答えたり、削減率の15%をそのまま答えたりすると、計算そのものが正しくても設問への答えが変わります。最後に「何の値か」を式の横へ書いて確かめましょう。
間違えた問題は、答えの数字だけを覚えるより、どの段階で条件を落としたかを見直すと次に使えます。木なら結合後の候補一覧、平均なら確率と回数の区別、容量なら付加情報と単位、復号なら確定後に根へ戻ったかを点検します。すべてを一度に解き直すのではなく、最初にずれた一行を見つけて、そこから計算を続けてみてください。
基本情報のデータ圧縮のまとめ
基本情報のデータ圧縮では、まず元のデータを完全に復元できるかで可逆・非可逆を判定します。そのうえで、ランレングスは連続する区間の長さ、ハフマン符号は記号の出現頻度という違いを確認します。「圧縮」「符号化」という言葉が共通していても、数える対象は異なります。
- ハフマン木は結合済みのまとまりも候補へ戻し、毎回小さい二つを選ぶ
- 符号は根から葉へ読み、符号長は枝の本数で数える
- 平均符号長は出現確率×符号長を足し、総量なら出現回数を使う
- 容量の比較は元の表現・付加情報・割合の定義をそろえる
学習を進めるなら、まず四記号の木を自分で作り、その符号表で短い文字列を符号化・復号し、最後に平均と総量を照合してみましょう。左右の0と1を変えた場合も同じ長さになるか確かめると、符号の形と効率の違いを説明できるようになります。
圧縮を含む分野全体の復習順を整理したい方は、基本情報の基礎理論が苦手な人向けの勉強法も確認できます。この記事の計算を追えた後は、分野全体の勉強法と、個別の符号化演習を行き来して理解を確かめてください。
続けて演習する場合は、サイトの基本情報過去問アプリで科目Aの公開問題を確認できます。無料で演習したい方に向く選択肢です。圧縮の問題だけが必ず表示されるとは限らないため、このページの例題と併用し、解けなかった問題は式の途中や条件の読み取りまで振り返りましょう。


コメント