DMAは、CPUが転送条件を整えたあと、専用の制御回路にデータ転送を任せる仕組みです。基本情報の学習では「CPUを介さない」と覚えますが、CPUが一切関与しないという意味ではありません。設定と完了後の処理はCPU側、転送中のデータ移動はDMA側、と時間を分けると整理できます。
この記事では、入出力装置から主記憶への転送を中心に、プログラム制御入出力や割込みとの違いを確認します。後半ではバースト方式とサイクルスチール方式を比べ、転送時間・CPUが処理する時間・バス待ち時間を区別してオリジナル例題を解きます。
- DMAでCPUが担当する設定と完了処理の範囲
- データを運ぶ仕組みと割込み通知を分ける考え方
- バースト方式とサイクルスチール方式のバスの使い方
- CPU占有時間と転送時間を取り違えずに計算する手順
基本情報のDMAとCPUの役割
DMAは誰がデータを運ぶのか
DMAはDirect Memory Accessの略で、直接メモリアクセス、直接記憶アクセスとも呼ばれます。中心となるのは、個々のデータをCPUの命令で読み書きする仕事を、専用の制御回路に任せることです。この制御回路をDMAコントローラ、DMACと呼びます。
たとえば、入出力装置が受け取ったデータを主記憶へ並べて保存する場面を考えます。CPUが運ぶ方式なら、CPUは装置側からデータを読み、主記憶へ書く処理を繰り返します。DMAでは、この反復するデータ移動をDMAコントローラが受け持ちます。CPUが転送先を指定することと、CPU自身が全データを移すことは別です。
ここでいう「直接」は、装置と主記憶をケーブルで直結するという意味ではありません。バスなどの経路や制御回路は使います。問われているのは接続端子の形ではなく、データ転送を誰が実行するかです。接続規格の整理は、基本情報の入出力インタフェースと転送方式で確認できます。
また、DMAコントローラが必ずCPUとは別の大きなチップとして存在するわけではありません。学習用の構成図ではCPU・主記憶・入出力装置・DMACを分けて考えると、役割を追いやすくなります。実装の違いより先に、この四者の分担を押さえましょう。
DMAは装置と主記憶の間だけでなく、メモリ間などの転送にも用いられます。対象範囲はOracleのDMA解説でも確認できます。この記事の例は、装置から主記憶への入力を基本にします。
転送前にCPUが設定すること
DMAコントローラは、転送したい内容を自分で判断して仕事を始めるわけではありません。典型的にはCPUがドライバなどのプログラムを実行し、どの装置のどのデータを、どこへ、どれだけ転送するかを設定します。入出力の要求を出したあとにデータが届く場面でも、転送先をあらかじめ用意する必要があります。
学習では次の項目を一組で覚えると、開始時のCPUの役割を説明しやすくなります。実機のレジスタ名や設定の順序、指定できる内容は機器によって異なるため、ここでは共通する考え方を取り出しています。
| 設定の観点 | 装置から主記憶へ入力する例 |
|---|---|
| 転送元 | 対象となる装置やデータレジスタを指定 |
| 転送先 | 主記憶上に用意した受信領域の開始位置を指定 |
| 転送量・転送単位 | 何個、何バイトを、どの単位で移すか指定 |
| 開始条件・動作方法 | 装置の要求などをきっかけに動かす設定 |
| 通知などの条件 | 完了や異常をCPU側で把握する方法を設定 |
たとえば「1個2バイトの測定データを100個、主記憶上の領域へ格納する」なら、必要なデータ量は200バイトです。「100個」と「100バイト」を同じにしてはいけません。転送回数はデータの個数であり、総バイト数は1個の大きさを掛けて求めます。
この例で、測定装置が同じデータレジスタへ次の値を順番に出すなら、転送元は固定し、主記憶側の格納位置を2バイトずつ進めるモデルで考えられます。両方のアドレスを必ず進めるとは限りません。実際のDMAにはアドレスの固定・更新を指定する仕組みがあり、MicrochipのDMAリファレンスマニュアルにも転送方向、サイズ、アドレス制御などが示されています。
転送中の流れを順番に追う
条件を設定した後は、DMAコントローラが転送要求に応じて動きます。ここでは、CPUとDMAが同じバスを共有し、DMAは指定した個数を転送したら終了する単純なモデルを想定します。回路内部の信号名を暗記する前に、次の順序を追ってみてください。
- CPUが主記憶の受信領域と転送条件を準備し、DMAを有効にする
- 装置からの要求などをきっかけに、DMA側が必要なバスの利用を求める
- バスの使用権を調整し、DMA側が装置のデータを主記憶へ転送する
- 設定に応じてアドレスや残り個数を更新し、必要な転送を繰り返す
- 所定の転送が終わったら完了を知らせ、CPU側が結果を処理する
主記憶へ書き込まれる途中の100個の値を、CPUが1個ずつ中継しているわけではありません。CPUに残る仕事は、前後の制御や、そのデータを使う計算です。測定データの平均値を求める処理まで、DMAが自動的に代行するとは考えないでください。
一方で、共有バスを使う構成では、DMAもCPUも同じ経路を同時には自由に使えません。DMAにバスを渡している間、CPUがそのバスを必要とすると待ちが生じます。「CPUがコピーをしない」ことから「CPUの実行に影響が出ない」と飛躍しないのが大切です。
CPUがほかの処理をどれだけ進められるかは、バス構成、キャッシュ、実行する処理などによります。CPUの仕事を減らせる仕組みであることと、共有資源の競合が残ることを両方押さえます。後半の方式比較では、バスを連続で使うか、細かく返すかに注目します。
プログラム制御や割込みとの違い
プログラム制御入出力とDMAは、「転送するデータをCPUの命令で運ぶか」という観点で比べられます。プログラム制御ではCPUが装置と主記憶の間のデータ移動を処理します。DMAでは設定後のデータ移動をDMA側が処理します。
対して、ポーリングと割込みは、状態変化や処理が必要になったことをどう知るか、という観点です。ポーリングではCPU側が状態を繰り返し確かめます。割込みでは通知をきっかけにCPUが対応します。通知方法と転送主体を一列に並べると、DMAと割込みのどちらか一方しか使えないように見えてしまいます。
| 確認したいこと | CPU側で行う形 | DMAを使う形 |
|---|---|---|
| データを誰が移すか | CPUが命令を実行して移す | DMAコントローラが移す |
| 処理が必要なことをどう知るか | 状態確認や割込みなど | DMAの状態確認や完了割込みなど |
| 両方を組み合わせられるか | 割込みを受けてCPUがデータを移せる | DMAで移した後に割込みで知らせられる |
たとえば、1文字届くたびに割込みを受け、CPUがその文字を主記憶へ保存するなら、通知は割込みでも、データを運んでいるのはCPUです。反対に、100個のデータをDMAで保存し、最後に1回の完了割込みを受けるモデルでは、データ移動と通知を別々の仕組みが担当しています。
したがって「割込みを使っているからDMAではない」という判断はできません。問題文に通知が登場しても、実際にデータを主記憶へ書く主体を探しましょう。割込みを受けたCPUの退避・復帰の流れは、基本情報の割込みと内部・外部の違いで整理できます。
完了後はCPUが結果を確認する
DMAで指定の転送が終わった後は、CPU側が完了状態や異常の有無を確かめ、受け取ったデータを後続の処理へ渡します。完了割込みを使う場合でも、「割込みが来た」という事実だけで、どの転送の通知か、正常に終わったかを無条件に決めつけるわけではありません。
OracleのDMA資源管理の例でも、割込み処理で状態を読み、通知の解除やエラー確認、次の転送への対応などを行っています。試験学習では具体的な関数名まで覚える必要はなく、CPUが終了時の制御を受け持つ、と捉えれば十分です。
ここまでの説明では、1ブロックの完了時にCPUへ知らせる形を基本にしました。ただし、実機には途中の通知や連続転送もあります。DMAを使うなら通知は必ず最後の1回だけ、と一般化しないようにしましょう。
また、一度の入出力要求が、必ず一度のハードウェア転送だけで終わるとも限りません。Microsoft LearnのDMAトランザクションと転送の説明では、要求の大きさによって複数の転送へ分割する場合が示されています。後半の例題で「設定1回・完了処理1回」とするときは、その条件を問題の前提として使います。
基本情報のDMAを方式と例題で理解する
バーストとサイクルスチール
DMAコントローラが共有バスを使う際には、CPUとの使い分け方が問題になります。基本的な比較は、まとまった量を続けて転送するバースト方式と、1転送単位ごとにバスを返すサイクルスチール方式です。どちらもDMAであり、CPUにコピーをさせる方式へ戻るわけではありません。
| 観点 | バースト方式 | サイクルスチール方式 |
|---|---|---|
| バスの使い方 | まとまった単位を連続して転送 | 1転送単位ごとに使用権を返す |
| CPUへの影響 | そのバスを使えない時間が連続しやすい | バスを使えない時間が細かく分かれる |
| 比較するポイント | 転送をまとめる効率と連続した待ち | CPUへバスを返す機会と切替えの負担 |
たとえば、4個のデータを同じバスで移す単純な例なら、バーストでは「DMA・DMA・DMA・DMA」と続ける形です。サイクルスチールでは、その間にCPUへ使用権を戻す機会を作ります。後者が常に「DMA・CPU」の厳密な交互になるとは限らず、実際の要求や優先順位も関係します。
また「1転送単位」は必ず1バイトという意味ではありません。問題文が1語、2バイトなどの単位を示していれば、それに従います。バーストも、アプリケーションが要求したデータ全部を必ず一度に運ぶ、という意味に固定しないでください。まとまりの大きさは実装や設定によります。
方式の概要とCPUへの影響は、Analog DevicesのDMAとバスアクセスの解説を参照できます。ここで比べるのは共有バスの利用方法です。DMAがバスを使うたびにCPU内部のすべての動作が必ず止まる、とまでは読み取らないことがポイントです。
例題でCPUの処理時間を求める
次は、DMAで減らせるCPUの仕事を数値で確認します。以下は仕組みを理解するためのオリジナル例題で、実機の性能値ではありません。CPUが命令を実行している時間を求め、バス待ちや割込み待ちなどは別として考えます。
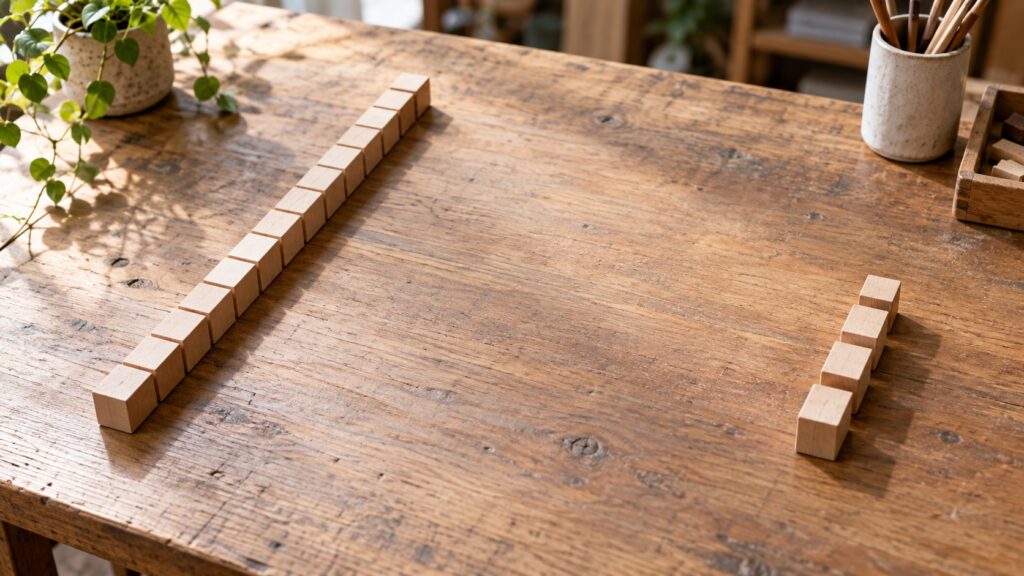
ある装置から4,000バイトを受信します。プログラム制御では1バイトの転送処理にCPU時間0.5μsが必要です。DMAでは開始設定に30μs、完了処理に10μsのCPU時間が必要で、全体を1回の設定と1回の完了処理で扱えるものとします。ほかのCPU処理とバス競合は無視します。それぞれのCPU処理時間と、削減率を求めてください。
- プログラム制御:4,000×0.5=2,000μs
- DMA:30+10=40μs
- 減ったCPU処理時間:2,000-40=1,960μs
- 削減率:1,960÷2,000×100=98%
答えはプログラム制御が2,000μs、DMAが40μs、削減率が98%です。DMA側で「4,000×40」としないのは、40μsが1バイト当たりではなく、今回のブロック全体の設定と完了処理だからです。時間の単位だけでなく、どの範囲に対する値なのかを読む必要があります。
検算では、40÷2,000=0.02から、残るCPU処理時間が元の2%だと確認できます。残る割合が2%なので、減る割合は98%です。「98%に短縮」と「98%削減」は異なります。前者なら2,000×0.98=1,960μsになり、この答えとは一致しません。
この計算から、データが届くまでの実時間も98%短くなるとはいえません。装置がデータを出す速さ、メモリへ移す速さ、バス待ちが分からないからです。求めたのはCPUの仕事の時間であり、入出力要求から完了までの経過時間ではありません。
同じ仮定でデータ量をNバイトとすると、プログラム制御は0.5Nμs、DMAは40μsです。CPU処理時間だけを比べた分岐点は0.5N=40より80バイトになります。80バイト未満ではこの条件のDMA設定・完了処理の方が重くなりますが、これは与えた値に基づく計算結果です。実機一般の「DMAは80バイトから有利」という基準には使えません。
例題でバス待ち時間を切り分ける
次は、DMAがCPUのデータ移動を肩代わりしても、共有バスの利用時間は必要になることを確かめます。前の例題と条件を混ぜず、ここでは別のモデルを使います。
DMAで1,000個のデータを転送し、1個につき共有バスを0.2μs使用するとします。観測区間は1msです。転送の切替え時間は無視し、CPUはその区間ずっと同じバスを必要としており、DMAがバスを使う時間はすべてCPUの待ち時間になるものとします。DMAによるバス占有時間と、観測区間に占めるCPU待ちの割合を求めてください。
- DMAによるバス占有時間:1,000×0.2=200μs
- 観測区間を統一:1ms=1,000μs
- CPU待ちの割合:200÷1,000×100=20%
この前提での答えは200μsと20%です。DMAがバスを使わない残りの時間は800μsになります。ただし、これを「CPUが必ず800μs分の有効な計算を終えられる」と読み替えるには、ほかの待ちや処理条件も調べる必要があります。
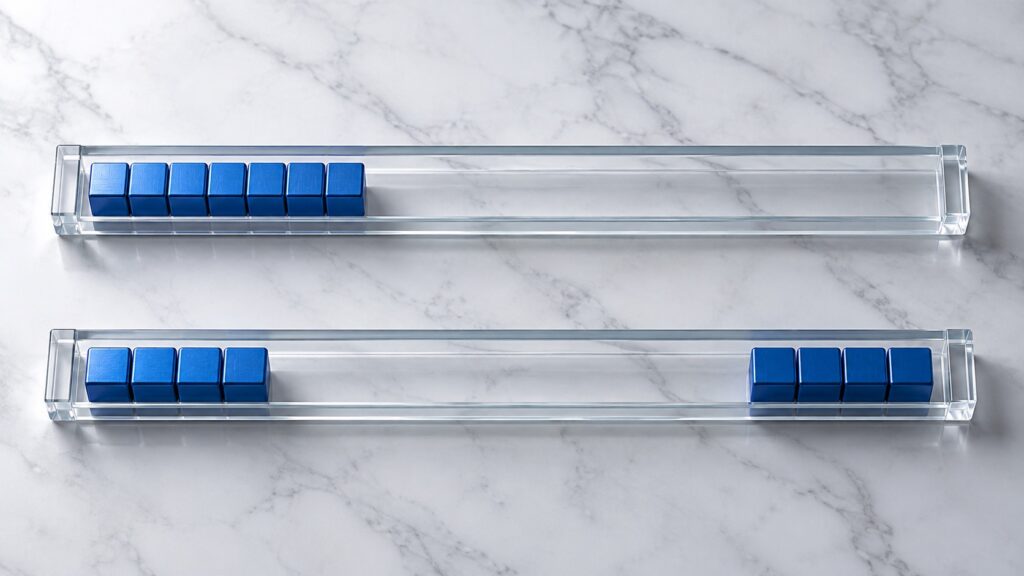
ここでバースト方式とサイクルスチール方式を比べるなら、合計200μsという長さと、それがどう分布するかを分けます。全1,000個を一度に連続転送するモデルなら、バスを使えない時間は200μs続きます。1個ずつ使用権を返すモデルなら、0.2μsずつの占有が分散します。
切替えの負担を無視した今回の計算では、両方式のDMAのバス占有時間の合計は同じです。相違は連続して待たされる長さや、途中でCPUがバスを使える機会にあります。実際に切替えの時間が掛かるなら、その負担も条件に合わせて加えます。「サイクルスチールだから待ち時間がゼロ」としてはいけません。
逆に、CPUがバスを必要としない内部処理を進められる条件なら、DMAのバス占有時間すべてがCPUの待ち時間になるとは限りません。200μsをCPUの待ちとできたのは、問題文で常に同じバスを必要とすると置いたからです。式の前に前提を一行書くと、適用できる範囲を見失いにくくなります。
選択肢は主語と時間軸を確認する
知識問題では「CPUを介さない」の一語だけで判断せず、誰が、いつ、何をするかを選択肢から取り出します。次の文を自分で判定してから、表の理由を読んでみてください。いずれもこの記事で整理した役割に基づくオリジナルの確認文です。
| 確認文 | 判定と理由 |
|---|---|
| DMAの開始条件はCPU側のプログラムで設定することがある | 適切。CPUの準備とDMAによるデータ移動は両立する |
| DMAなら転送中のすべてのデータをCPUの汎用レジスタで中継する | 不適切。それではCPUが個々のデータを運ぶ説明になる |
| DMAの転送完了を割込みでCPUへ知らせることがある | 適切。転送と通知は組み合わせられる |
| サイクルスチールではDMAがバスを一切使用しない | 不適切。バスを細かく使い、使用権を返す方式である |
| DMAのCPU処理時間が小さければ、入出力の完了時間も同じ割合で短くなる | 不適切。装置やバスの時間は別に確認する必要がある |
最初の文を「CPUが設定するのでDMAではない」と判断したら、設定と転送を混同しています。3番目の文を「割込みだからDMAではない」と判断したら、通知と転送を混同しています。誤答を暗記するより、混ぜてしまった二つの役割を言葉にすると直しやすくなります。
計算問題では、数値の横に「1バイト当たり」「1ブロック当たり」「バスの利用時間」「観測区間」と書き添えましょう。CPU処理時間の比較で転送速度を勝手に使ったり、バス待ちの割合で分母となる区間を省いたりすると、計算そのものが合っていても別の量を求めてしまいます。
まとめ:基本情報のDMAを整理する
基本情報のDMAは、CPUが準備し、専用回路がデータを移し、CPU側が完了後の処理をするという流れで捉えると理解しやすくなります。CPUを介さないのは個々のデータの転送であり、設定や後処理まで消えるわけではありません。
割込みは通知の仕組みなので、DMAと組み合わせられます。バーストとサイクルスチールは、DMAが共有バスをまとめて使うか、細かく返すかの違いです。CPUがコピーをしないことと、バス待ちの影響がないことは分けて考えましょう。
復習では、紙にCPU・DMAC・装置・主記憶の四つを書き、「設定」「データ移動」「完了通知」の矢印を説明してみてください。そのあと、例題のデータ量や設定時間を一つ変え、CPU処理時間とバス待ちのどちらを求めているかを口に出してから計算すると、用語の暗記から問題を解く理解へつなげられます。
解説を読んだら、基本情報の過去問アプリで無料演習に進み、答えだけでなく選んだ理由も確かめてみてください。
コメント