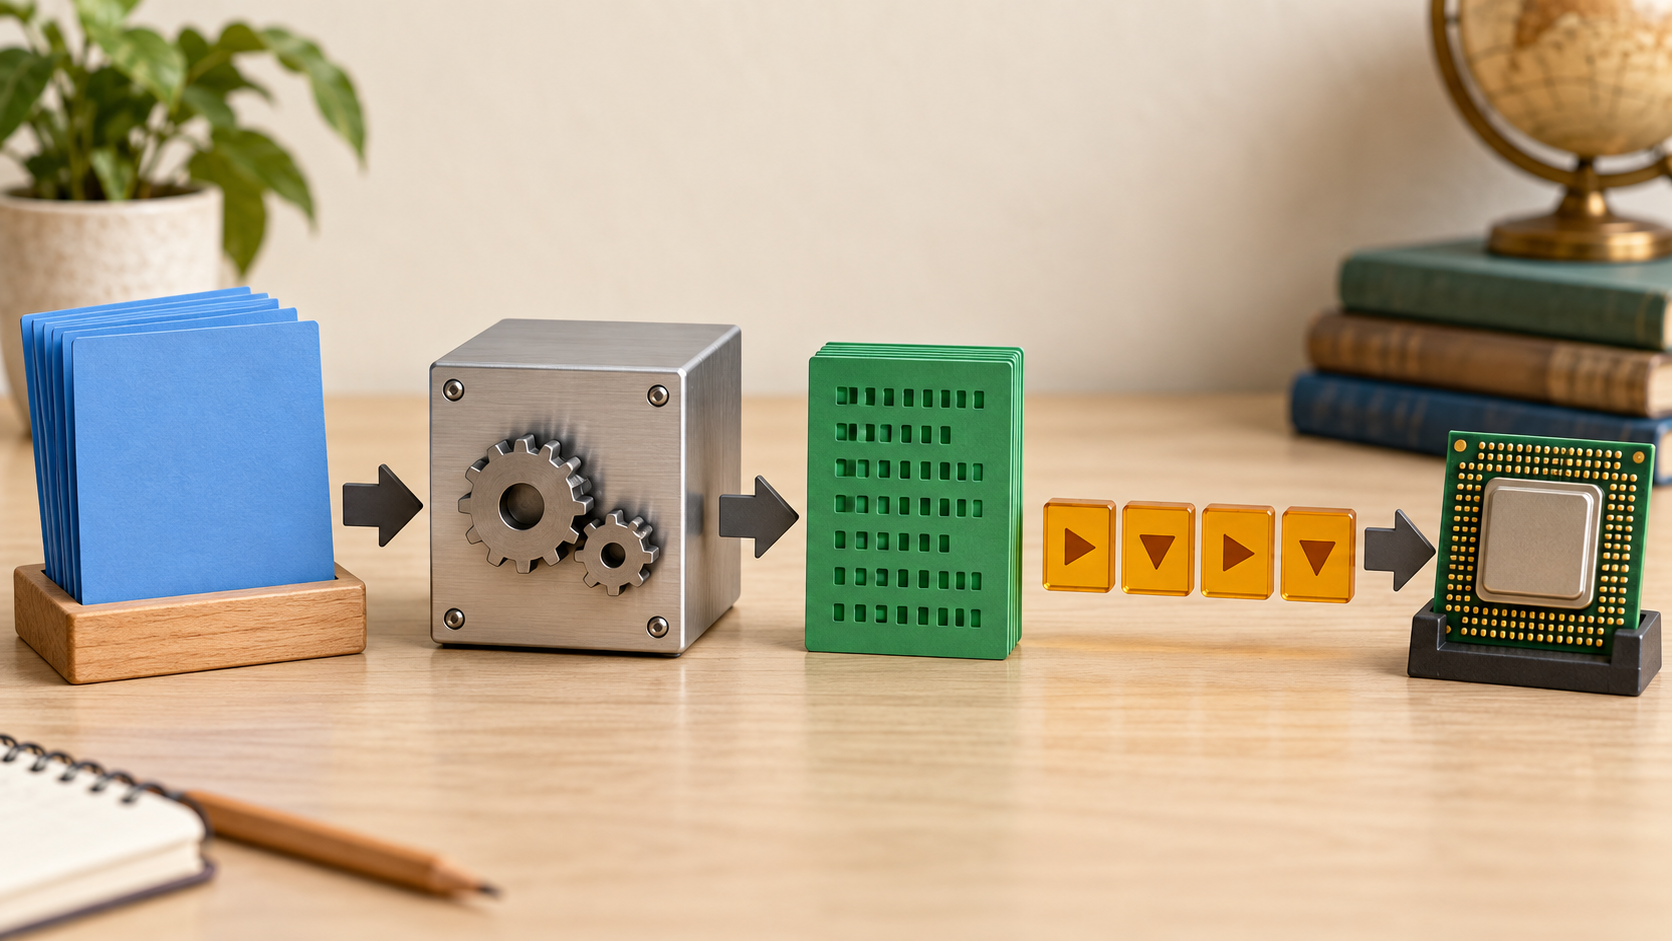
基本情報のコンパイラとインタプリタは、「まとめて翻訳」と「解釈しながら実行」という違いから押さえると整理できます。ただし、その覚え方だけでは、中間コードを実行するJavaやPython、実行中に翻訳するJITが出たときに迷いやすくなります。
科目Aで見るべきなのは、言語の名前よりも「何を受け取り、何を作り、いつ実行するか」です。この記事では翻訳から実行までの流れを整理し、字句解析・構文解析・意味解析、リンカ、ローダを自作例題で見分けます。実行時間の比較も、翻訳時間を含める条件から判断できるようにしていきましょう。
- 翻訳結果を作る処理と、その場で命令を実行する処理の違い
- 字句・構文・意味の三つの解析が調べる対象
- リンカの結合とローダの読み込みを見分ける手順
- 中間コード・JIT・実行時間の条件を使った例題の解き方
基本情報のコンパイラとインタプリタの違い
最初に全体像をつかみ、その後で細かい工程を分けます。ソースコードが読めなくても、処理前と処理後の状態が説明できれば、用語を問う選択肢は判断できます。
翻訳する処理と実行する処理
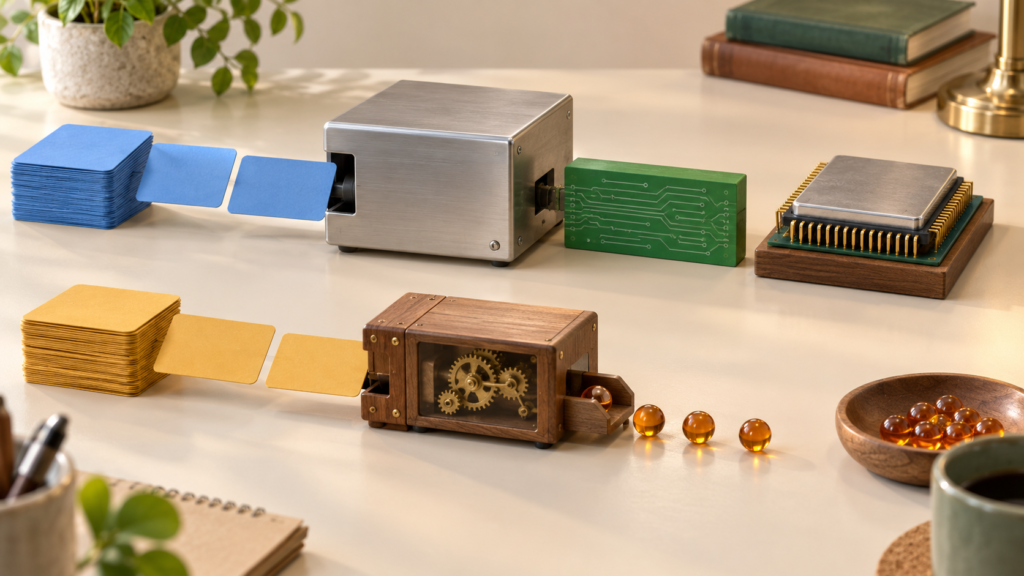
コンパイラは、プログラムを別のコード表現へ翻訳する言語処理プログラムです。基本情報では「原始プログラムを目的プログラムへ翻訳する」という表現を押さえます。原始プログラムは人が記述したソースコード、目的プログラムは翻訳の結果として得られるプログラムを指します。
ここで大切なのは、翻訳結果を作ることと、そのプログラムの計算を実行することは別だという点です。合計値を求めるソースコードをコンパイルしても、それだけで入力データの合計が画面に出るわけではありません。生成されたコードを実行する段階で、入力や計算、出力が行われます。
インタプリタは、プログラムの命令を解釈し、その意味に従って実行する処理系です。「解釈しながら実行する」が区別の中心になります。教材では「1文ずつ」「逐次」と表現されますが、ソースファイルの物理的な改行を1行ずつ機械語へ変換するという厳密な定義ではありません。複数行にまたがる式や、一つの行に複数の文がある場合も扱えるからです。
| 比較軸 | コンパイラ | インタプリタ |
|---|---|---|
| 中心となる仕事 | 別のコード表現へ翻訳する | 命令の意味を解釈して実行する |
| 典型的な流れ | 翻訳結果を作り、その後で実行する | 解釈と実行を進める |
| 生成物・結果 | 機械語や中間コードなどの翻訳結果 | 命令に従った処理の結果 |
| 試験での判断語 | 原始プログラム・目的プログラム・翻訳 | 解釈・逐次・実行 |
「コンパイラは翻訳、インタプリタは実行」と最初に分けてください。ただし実際の開発環境では、コンパイラを呼び出した直後に実行する操作もあります。画面上の実行ボタンが一つでも、内部の役割が一つとは限りません。操作の見た目より、問題文が説明する仕事を優先しましょう。
コンパイルの各段階を追う
コンパイルの内部では、文字の並びを調べ、文の構造を組み立て、意味の整合性を確認してから、実行に使うコードへ変換します。IPAの基本情報技術者試験シラバスVer.9.2でも、字句解析、構文解析、意味解析、コード生成、最適化が学習項目になっています。工程名だけでなく、それぞれの対象を対応させるのが学習の近道です。
説明用に、整数型の変数totalへ「price+10×2」を代入するプログラムを考えます。priceも整数型で、事前に宣言されているとします。ここで示すコードや条件は理解のための例で、特定の言語の細かな仕様を問うものではありません。
字句解析では、文字列を意味のある単位であるトークンに区切ります。変数名total、代入記号、変数名price、加算記号、整数の10、乗算記号、整数の2などを認識する段階です。「文字の並びから単語や記号を取り出す」と読めば、この工程だと判断できます。空白を取り除くだけの処理ではなく、識別子、数値、演算子などの種類も区別します。
構文解析では、トークンの並びが文法に合っているかを調べ、式や文の構造を組み立てます。「10×2」が先に計算され、その結果をpriceに足すというまとまりを捉えます。演算子の優先順位や括弧の対応を扱うのもこの段階です。price+×2のように演算子のつながりが文法に合わない例は、構文の問題として考えます。
意味解析では、文の形が正しくても意味上の条件を満たしているかを調べます。静的な型検査を行う言語なら、変数が宣言済みか、代入する値の型と変数の型が整合するかなどを確認します。単語に分けられること、文法に合うこと、型などが整合することは、別々のチェックです。
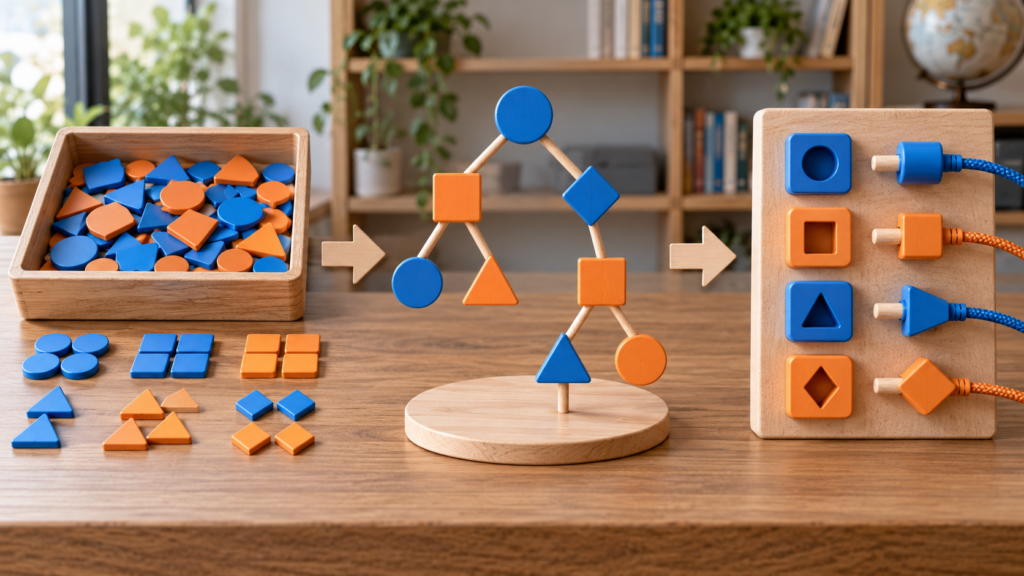
その後は中間コードの生成、最適化、対象のコード生成へ進むという流れで整理できます。中間コードは、ソースコードと最終的な機械語などの間に置く表現です。前半で言語の構造を整理し、後半で実行環境に合わせた命令へ変換するための橋渡しになります。すべての処理系が同じ形式の中間コードを使うわけではありません。
最適化は、言語の規則に従ったプログラムの振る舞いを保ちつつ、実行時間や使用資源などの効率を改善する処理です。先ほどの整数式なら、10×2という定数同士の計算を20へ置き換えることが一例になります。毎回同じ計算を実行する必要がなくなるので、計算の仕事を減らせます。
ただし「どんな計算でも順番を変えてよい」「使用していない変数に見えれば、その計算をすべて消せる」と覚えるのは危険です。入力や画面への出力、例外の発生など、外から観測できる振る舞いが変わる可能性があります。最適化の選択肢では、処理効率を上げることに加え、結果や必要な動作を変えないことも確認します。
コード生成は、解析された構造や中間表現から、対象に合わせたコードを作る段階です。出力先はCPUの機械語に限りません。アセンブリ言語や、仮想マシン向けのバイトコードなどもあります。「目的プログラム」という言葉を「そのPCですぐ起動できる完成した実行ファイル」とだけ結び付けないことが大切です。
この流れは理解用の整理です。実際のコンパイラでは、最適化を複数の段階で行ったり、解析と変換を組み合わせたりします。試験で段階の役割が問われたら、実装の細部を想像するより、入力と出力の説明を照合してください。字句解析と構文解析の具体例は、LLVMの字句解析チュートリアルと構文解析・構文木の解説でも確認できます。
文法そのものの表し方が分からない場合は、基本情報のBNF・構文図の読み方を先に確認すると、構文解析が照合する「文法」の意味をつかめます。ここでは文法記号の読み取りではなく、言語処理のどの段階に当たるかを区別します。
リンカとローダの役割を分ける
ソースコードの翻訳が終わっても、使う関数や部品を結び付ける仕事と、実行のためにメモリへ配置する仕事が残ることがあります。リンカとローダは、この二つを区別するための用語です。翻訳、結合、読み込みの順で、扱うものが変わる様子を想像しましょう。
リンカは、複数の目的プログラムやライブラリを結び付け、参照関係を解決するプログラムです。たとえば本体から計算用の関数を呼ぶ場合、その関数が別のファイルに実装されているなら、本体の呼出しと関数の実体を対応させる必要があります。名前を見つけて呼出し先につなぐ仕事は、単にソースコードの文法を調べる仕事とは異なります。
ローダは、実行するプログラムを主記憶へ読み込み、実行を始められる状態にする役割を持ちます。「主記憶装置にロードする」という説明があれば、基本情報ではローダを候補にします。目的プログラムを結合するリンカと、読み込むローダを、どちらも「実行準備だから同じ」とまとめないようにしてください。
| 処理 | 主に扱う対象 | 何をするか |
|---|---|---|
| コンパイル | 原始プログラム | 目的のコード表現へ翻訳する |
| リンク | 目的プログラム・ライブラリ | 部品を結合し、参照先を解決する |
| ロード | 実行可能なプログラム | 主記憶へ読み込み、実行を準備する |
| 実行 | 配置された命令・入力データ | 計算や入出力を行う |
C言語の一般的なツールの流れは、前処理、コンパイル、アセンブル、リンクと整理できます。前処理はマクロやファイル取り込みなどを扱い、アセンブラはアセンブリ言語を機械語のコードへ変換します。GCCの公式文書では、これらの段階と、リンク前で止める-cオプションが区別されています。
GCCを一度呼び出すと複数段階が連続して動くことがありますが、それを根拠に「リンカも字句解析をする」とは考えません。また動的リンクでは、起動時や実行時に共有ライブラリとの結び付けを行う場合があります。基本的な直線の流れを押さえたうえで、問題文が動的な処理を指定しているなら、その条件に従ってください。
中間コードは機械語と同じではない
中間コードやバイトコードは、元のソースコードを処理しやすい形へ変換した表現です。CPUが直接実行する機械語と、仮想マシンが扱う命令は、実行主体が違います。この区別ができると、「コンパイル済みなのにインタプリタが必要」という説明も矛盾なく読めます。
Javaの標準的な開発ツールjavacは、Javaのソースファイルを、Java仮想マシンで動くクラスファイルへコンパイルします。クラスファイルに含まれるバイトコードは、そのまま特定のCPU向け機械語と同じものではありません。Oracleのjavac公式文書では、ソースファイルからクラスファイルを生成する仕事が説明されています。
Pythonでも、代表的な実装であるCPythonは、ソースコードをバイトコードへコンパイルします。そして処理系がそのバイトコードを実行します。Python公式用語集のbytecodeにも、この変換と実行の説明があります。「Pythonではコンパイルが一切行われない」という断定は、CPythonの動作を説明していません。
なお、バイトコードがあるからといって、あらゆる処理系や版で同じファイルがそのまま使えるとは限りません。CPythonのバイトコードも実装や版をまたぐ安定した共通形式として扱えるわけではありません。基本情報の問題で大切なのは、互換性を無条件に広げることより、変換後のコードを誰が実行するかを区別することです。
言語名だけで分類せずJITを読む
プログラミング言語は文法や意味の規則を定め、処理系はそのプログラムをどう動かすかを実装します。したがって「この言語名なら必ずこの方式」と一対一で固定すると、同じ言語を扱う別の処理系や、複数方式を組み合わせた環境を説明できなくなります。代表例は入口として使い、正解の根拠は問題文の動作に置きましょう。
JITはJust-In-Timeの略で、実行時に対象のコードを機械語などへコンパイルする方式です。事前にすべてを変換するAOTと比べ、翻訳する時点が実行中にあるのが特徴です。実行時に働くからといって、翻訳結果を作る仕事までインタプリタと呼ぶわけではありません。
HotSpotのような実装では、解釈による実行とコンパイルを組み合わせ、実行中の情報を最適化へ利用します。よく使われる部分を効率のよいコードへ変換する、と捉えると分かりやすいですね。OracleのHotSpotの性能改善に関する文書でも、インタプリタ、コンパイラ、実行時の情報収集を組み合わせる説明が確認できます。
JITの効果を考えるときは、翻訳に掛かる時間も必要です。長く繰り返す処理なら、最初の翻訳コストを、その後の短い実行時間で取り戻せる可能性があります。一方、すぐ終了する処理では、翻訳コストの割合が大きくなる場合があります。「JITなら、どんな処理も開始直後から必ず速い」とは判断できません。
こうして見ると、コンパイラとインタプリタは対立する言語の名前ではなく、処理の役割です。ソースからバイトコードへの変換、バイトコードの解釈実行、必要な部分の機械語へのJITコンパイルは、一つの処理系の中に共存できます。選択肢に「中間コード」とあれば、どの変換・どの実行について説明しているかを読み直しましょう。
基本情報のコンパイラとインタプリタの例題
ここからは科目Aを意識した自作例題です。実際の過去問を転載したものではありません。用語の定義だけでなく、工程を取り違える選択肢と、翻訳時間を落としやすい計算条件を確認します。先に自分の答えを決めてから説明を読むと、迷う場所を見つけやすくなります。
入力と出力と時点で判断する
選択肢を読むときは、まず入力されるものに注目します。原始プログラムなら翻訳や解釈、目的プログラムとライブラリなら結合、実行可能なファイルならロードという候補が立ちます。次に、何を得るか、処理がいつ行われるかを確認すると、候補を絞れます。
- 対象を丸で囲む:原始プログラム、目的プログラム、ライブラリ、実行ファイルなど
- 動詞に線を引く:翻訳する、解釈して実行する、結合する、読み込むなど
- 処理後の状態を書く:別のコードができる、参照が解決する、主記憶に配置されるなど
- 実行時点を確認する:実行前の翻訳か、実行しながらの解釈か、実行中の翻訳か
たとえば「実行中に中間コードを機械語へ変換する」は、「実行中」という時点だけならインタプリタに見えます。しかし動詞は変換、生成物は機械語なので、JITコンパイルとして読む説明です。「逐次」という一語だけで決めず、仕事の内容を最後まで照合してください。
反対に「ライブラリ内の関数と目的プログラムの呼出しを結び付ける」は、実行前に行われることが多くてもコンパイルの定義ではありません。対象が目的プログラムで、仕事が参照の解決だからです。用語が出てくる順番や「高速」という印象ではなく、対象と動詞の組合せを選ぶと判断が安定します。
言語処理系の説明を選ぶ例題
例題:次の四つの説明のうち、インタプリタの中心的な役割に当たるものはどれでしょうか。
- ア:別々に作成された目的プログラムの呼出し先を結び付ける
- イ:命令の意味を解釈しながら、指定された処理を実行する
- ウ:原始プログラムを別のコード表現へ翻訳する
- エ:実行可能なプログラムを主記憶へ読み込む
正解はイです。単に命令を読み取るだけでなく、解釈に基づいて実行することが説明されています。ウもソースコードを扱いますが、中心は翻訳結果の生成なのでコンパイラです。アはリンカ、エはローダに対応します。各選択肢を一つの用語へ結び付けられれば、似た文章へ置き換えられても対応できます。
ここで「原始プログラム」が書かれていないからイは誤り、と考える必要はありません。インタプリタが扱う表現は、ソースコードそのものだけとは限らないからです。問題文が入力を明示している場合はその条件を使いますが、定義で最も強い手掛かりは「解釈しながら実行する」という仕事です。
確認問題:ある処理系では、ソースコードからバイトコードを生成し、その後、バイトコードを解釈して処理するものとします。この処理系は、コンパイルとインタプリタによる実行の両方を含むと考えてよいでしょうか。
答えは、含むと考えてよい、です。前半は翻訳結果を作る段階、後半はその意味を解釈して実行する段階です。「コンパイルを含む処理系ではインタプリタを使えない」という制約はありません。コンパイラとインタプリタの基本的な違いを覚えることと、両者が同じ環境で使われることは両立します。
解析とエラーの段階を見分ける
次の例題では、静的な型検査を行う説明用の言語を想定します。整数型と文字列型は別で、未宣言の変数は使えず、整数型変数へ文字列をそのまま代入できないものとします。どの言語でも同じ挙動だと決め付けず、ここで与えた規則を使ってください。
| 例題の状況 | 該当する段階 | 判断の理由 |
|---|---|---|
| 変数名や数値、演算子を切り出す | 字句解析 | 文字列をトークンへ区切っている |
| 「a+×3」が文法の規則に合わない | 構文解析 | 演算子の並びが式として成立しない |
| 宣言されていない変数を使用している | 意味解析 | 文の形ではなく名前の使用条件を調べる |
| 整数型の変数へ文字列を直接代入する | 意味解析 | 型の整合性を調べる |
| 定数だけの計算を同じ値へ置き換える | 最適化 | 振る舞いを保ちながら処理を減らす |
字句解析と構文解析で迷ったら、「単位を取り出す仕事」か「単位の並びを調べる仕事」かを分けます。a、+、×、3というトークンを認識できても、a+×3が正しい式になるとは限りません。単語が分かることと文章が成立することを分けるのと同じです。
構文解析と意味解析で迷ったら、「文の形の違反」か「名前・型などの条件の違反」かを分けます。文法として代入文の形になっていても、左側に未宣言の変数があれば意味の条件を満たせません。BNFの記号を長く展開するより、何の規則と照合しているのかを説明できることが、この問題の目的です。
続いて、ソースの翻訳は成功したのに、別ファイルにあるはずの関数の実体が見つからず、結合に失敗したとします。これは、この例ではリンク段階の問題です。ソースの構文や型が正しいことと、必要な部品がそろっていることは別です。GNUリンカの公式文書でも、解決できないシンボル参照をエラーとして扱う条件が説明されています。
さらに、実行に必要な外部ファイルが存在しない、実行時の入力が想定外だった、分岐先でエラーが起きた、といった問題は、コンパイル成功だけでは防げません。「コンパイルで全エラーを検出できる」という選択肢は、検出対象を広げすぎています。逆にインタプリタでも、実行前に文法を確認する実装があるため、「必ずその行まで動いてから構文エラーが分かる」とは言い切れません。
ロード後にプログラムをCPUへ割り当てる仕事は、スケジューリングなどOS側の論点へつながります。プロセスを実行する順番と、実行用コードを作る段階を混同しているなら、基本情報のOSとスケジューリングを参照してください。翻訳・ロード・CPUの割当てを分けると、全体の流れが見やすくなります。
翻訳時間を含めて速さを比べる
「コンパイラ方式は高速」という特徴は、翻訳後のコードの実行を比べるときの一般的な説明です。試験で全体の所要時間を比べるなら、コンパイル時間、固定の起動時間、実行回数などの条件を加える必要があります。最初の1回と、多数回繰り返す場合の結論は同じとは限りません。
例題:同じ処理をインタプリタ方式で実行すると、1回につき0.12秒掛かるものとします。コンパイラ方式は最初に0.50秒の翻訳が必要で、翻訳後の実行は1回につき0.02秒です。翻訳結果は再利用でき、入力データだけを変えて繰り返します。ほかの時間は考えないとき、何回以上ならコンパイラ方式の合計時間が短くなるでしょうか。これらは計算練習用の仮定値です。
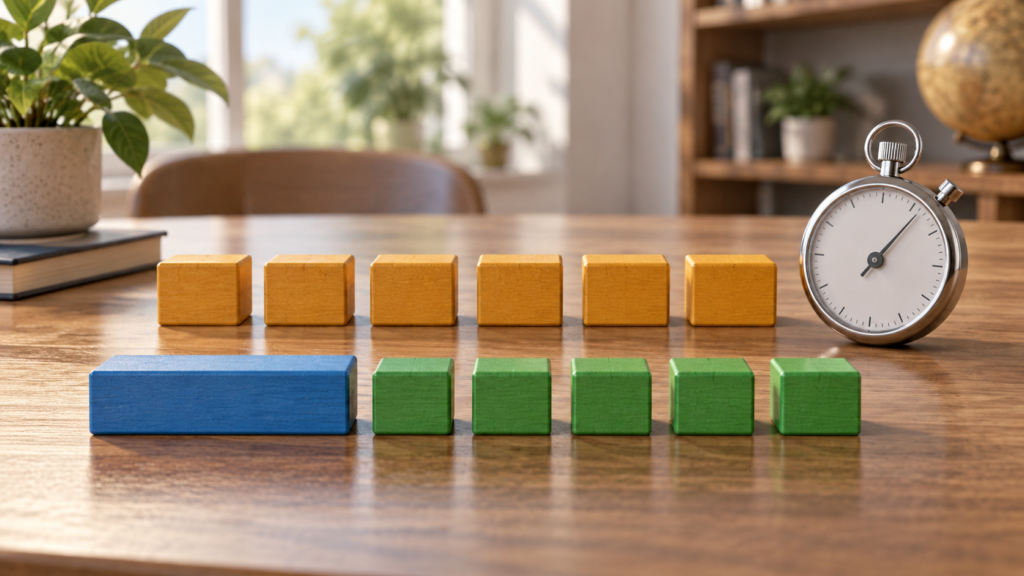
実行回数をnと置くと、インタプリタ方式の合計時間は0.12n秒です。コンパイラ方式は、最初に一度掛かる0.50秒と、各回の実行時間0.02n秒を足して、0.50+0.02n秒になります。翻訳時間を毎回足す式にしないよう、再利用できるという条件を確認します。
コンパイラ方式のほうが短い条件は「0.50+0.02n<0.12n」です。両辺から0.02nを引くと「0.50<0.10n」、したがって「5<n」です。回数は整数なので、答えは6回以上になります。5回ではどちらも0.60秒で、同じ時間です。「短くなる」と「同じになる」の境目を区別してください。
| 実行回数 | インタプリタ方式 | コンパイラ方式 | この条件での比較 |
|---|---|---|---|
| 1回 | 0.12秒 | 0.52秒 | インタプリタ方式が短い |
| 5回 | 0.60秒 | 0.60秒 | 同じ |
| 6回 | 0.72秒 | 0.62秒 | コンパイラ方式が短い |
| 10回 | 1.20秒 | 0.70秒 | コンパイラ方式が短い |
条件を変え、プログラムを毎回修正して、実行前に0.50秒の翻訳をやり直すとしたらどうでしょうか。この場合はコンパイラ方式が「(0.50+0.02)n=0.52n秒」になります。同じ数値でも翻訳結果を再利用できないため、この仮定では実行回数を増やしてもインタプリタ方式を下回りません。
問題によっては、行数に比例するコンパイル時間と、行数に関係なく発生する固定時間が両方与えられます。固定時間は行数に掛けず、比例する時間だけを行数へ掛けてください。「100行当たり」の条件なら、行数をLとしてL÷100を使うなど、単位をそろえると混乱しにくくなります。
これは実際の言語の性能ランキングを求める計算ではありません。与えられたモデルの中で、費用の発生回数と単位を正しく数える練習です。ネットワーク待ちや入力処理が大きいプログラムなどは、言語処理の速度だけで全体時間が決まりません。問題文で無視してよい時間と含める時間を、最初に区別しましょう。
基本情報のコンパイラとインタプリタを整理
復習では、用語を見て定義を言う方向だけでなく、説明を見て用語を選ぶ方向も練習しましょう。「原始プログラムから目的プログラムを生成する」と読んでコンパイラ、「解釈しながら実行する」と読んでインタプリタ、と答えたあとに、なぜほかの用語ではないかを一文で説明します。
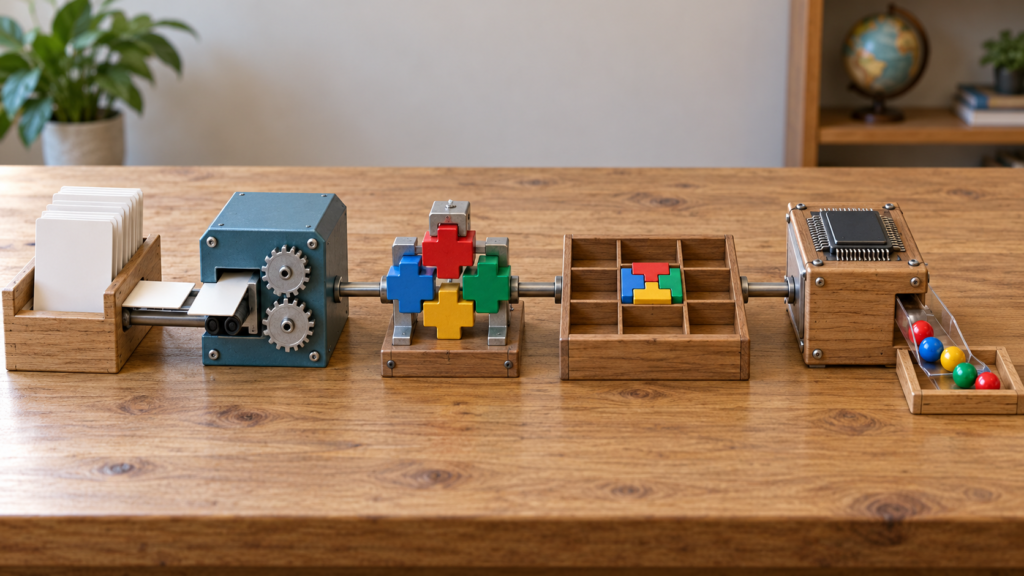
コンパイルの段階は、文字を単位に分ける字句解析、文の構造を調べる構文解析、名前や型などの条件を調べる意味解析、振る舞いを保って効率を改善する最適化、目的のコードを作るコード生成という役割で区別します。リンカは部品を結び付け、ローダは実行用プログラムを主記憶へ読み込みます。
中間コードが出てきたら、ソースから何へ変換したのか、そのコードを誰が実行するのかを確認します。JITが出てきたら、実行時に翻訳結果を作る処理として捉えます。JavaやPythonという言語名が分かっても、その名前だけで処理系全体を一つの方式に固定しないことが大切です。
実行時間の問題は、翻訳に掛かる時間と実行に掛かる時間を別々に書き、何回ずつ発生するかを確かめます。翻訳結果を使い回すのか、毎回翻訳するのかで式が変わります。境目が求まったら、その回数では同じ時間なのか、短くなるのかを実際に代入して確認してください。
用語の区別が説明できたら、基本情報の過去問アプリで問題演習へ進めます。正解した問題も、選ばなかった説明がどの役割に対応するかを確認すると、表現の違う選択肢に対応しやすくなります。
コメント